本文へ移動
AI NEWS JOURNAL
FOLLOW THE THREAD

AI 视频

テーマに沿って、新しい事実とその後の進展を追います。

公開日時順

MetaがAIファッションアプリ「Style Sketch」を静かにリリース、バーチャルクローゼットとAI試着をサポート

MetaはAIファッションアプリ「Style Sketch」を発表しました。このアプリは既存の衣類をデジタル化し、AIによって個別化されたコーディネート提案を生成します。同アプリはインドネシア、シンガポール、タイのiOSおよびAndroidプラットフォームで提供されており、現時点では世界的な展開計画はありません。Instagramとの連携も可能で、写真を元に自動的にバーチャルクローゼットを構築できます。また、写真撮影や短い動画、アルバムからの選択により手動で服を追加することもでき、クローゼット内容と個人のスタイルを組み合わせてコーディネートを提案します。

QQ20261030-090653.jpg
経緯と関連報道

レックス・フリードマンのポッドキャスト精読|AIの衝撃下で、数学者には何が残るのか?

レックス・フリードマンの今回の回は、13のテーマに分かれています。ゲストは3名で、ワシントン大学で流体力学を研究するスティーブン・ブラントン、MITで理論計算機科学に取り組むアンカー・モイトラ、そしてラトガース大学で数論とLeanを研究するアレックス・コントラヴィチです。動画では、ナビエ–ストークス方程式、リーマン予想、計算複雑性理論について議論されており、その背景には、わずか数週間の間にAIがこれらの分野で未解決だった難題を相次いで解明したと発表されたことがありました。3人の数学者はそれぞれの専門的視点から、それらを丁寧に分解して解説しています…

Lex Fridman播客精读|AI冲击下,数学家还剩下什么?
経緯と関連報道

Manusが、先ほど静かに自らの2.0宣言を発表しました

10月26日、Manusの共同創業者でプロダクトパートナーである張涛(ネットネームはHideCloud)は、自身の公式アカウント「潜雲思緒」に『ManusでManusを改造する』というタイトルの長文を投稿しました。記事の冒頭には、彼にとって非常に印象深い光景が描かれています。彼がエンジニアにいくつかの要件やバグを伝え、しばらくして進捗を確認すると、相手のパソコンにはCodexとManusのセッションがずらりと並んでいました。そのうちのひとつを適当に開くと、入力されているのはまさに先ほどSlackで送った要件の原文で、一字も修正されていませんでした。さらに驚いたことに、そのエンジニアは同時に十数件から二十件もの要件を処理していたのです。今日のManusでは、これはすでに日常的な光景となっています。 この記事は情報量が非常に多く、特に記憶しておくべきポイントがいくつかあります。Manus内部では「Manus-mono」という統一コードエントリーポイントを設け、AI向けのマニュアルまで用意することで、AIがリポジトリを跨いだ全体像を把握できるようにしています。ひとつの要件について、一人で全エンドの実装を完了することも可能です。モバイルチームは常に7名しかおらず、同時に2つのプロダクトと4つのアプリを担当していますが、進行状況はWeb版とほぼ同期しています。 すべてのプロダクトマネージャーがManusにコードを提出しており、その約半数が要件を独立して本番環境へとデプロイしています。中には、提出された要件がドキュメントから動画にまで仕上がっているケースもあります。 マーケティングチームには「デジタル同僚」が加わり、自らタスクをスケジュールし、プロジェクトの進捗を積極的に通知するとともに、チーム間で機能の詳細を確認する役割も担っています。 9月には、同社のAI関連費用が一人当たり1万ドルを超え、なかには月に7〜8万ドルを費やす者もいました。張涛はこうした外部からの疑問に対し、わざわざ一節を割いて回答しています。 記事の公開タイミングもまた微妙です。9月下旬にはManusが2.0版および個人用インテリジェントエージェントアプリ「Cue」をリリースし、10月初めには親会社の「蝴蝶効應」が5億ドル超の新規資金調達を完了すると同時に、北京で17の求人を出したのです。この時期に見ると、この記事はむしろManusチームが2.0時代へと突入したことを示す宣言のようにも映ります。そこでは組織がいかにしてAIを活用して進化していくかが語られるとともに、同社の製品戦略、コスト構造、採用基準といった核心的な要素が垣間見えます。 01 Manusそのものが、まさに2.0のモデルルームなのです。もし記事に登場する社内での実践とManus 2.0の機能リストを並べてみると

経緯と関連報道

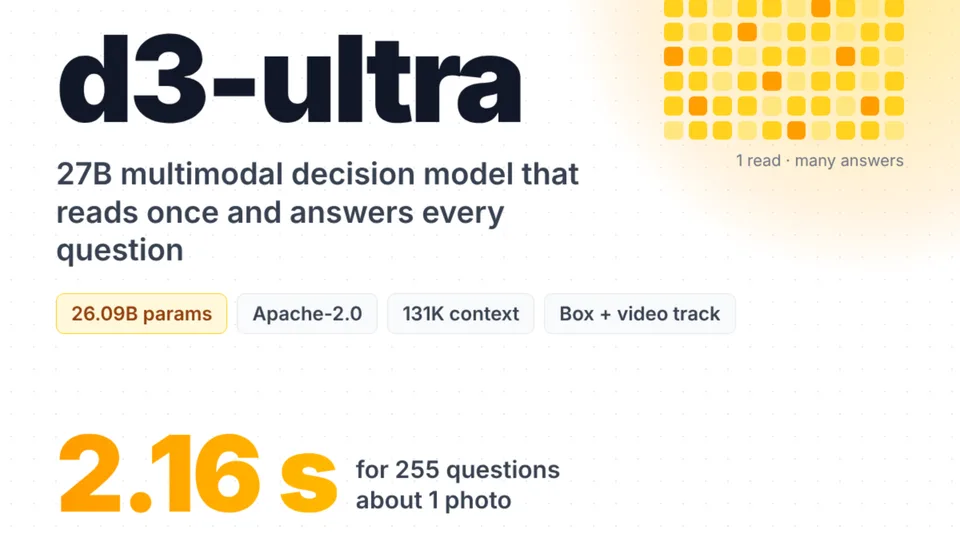
vLLM セマンティックルーターが d3-ultra をリリース:270億パラメータのオープンなマルチモーダル意思決定モデル

vLLMセマンティックルーターは、270億パラメータ規模のオープンウェイトなマルチモーダル意思決定モデルであるd3-ultraをリリースしました。同モデルはテキスト、画像、動画を一度に読み込み、各回答に対する確率を返却し、チームのSR-Textテストで87.2点を獲得しています。この記事「vLLMセマンティックルーター、270億パラメータ規模のオープンマルチモーダル意思決定モデルd3-ultraをリリース」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

PhaseBreak:不正な画像から動画へのアニメーション生成に対する先制的時間的保護

arXiv:2610.33070v1 発表タイプ:新規 要旨:画像から動画へ(I2V)の拡散モデルは、単一のポートレートや写真をアニメーション化し、被写体の許可なしに共有された画像をモーション合成に再利用可能にします。私たちは、このような用途に対する先制的な視覚的保護を検討しています。すなわち、画像が公開される前に、所有者が共有ワークフローを維持しつつ、下流のモーション生成を妨害する制限付きの摂動を加えます。既存のスペクトル破壊手法は、時間的表現を全体的に減衰させるため、微妙な動きや空間的に局在した動きに対しては十分な制御が得られません。私たちの核心的なアイデアは、生成される動態が時間的特徴の強度だけでなく、特徴イベントの発生順序にも依存することです。そこで、我々はホワイトボックス型のスペクトルリタイミング保護手法であるPhaseBreakを提案します。

経緯と関連報道

v0.43.0

## 変更点 * model_prefetch:https://github.com/Comfy-Org/ComfyUI/pull/17178 で @rattus128 により、すべてのグラフクリーンアップを同期化 * MOSS-image にロープスケーリング対応を追加:https://github.com/Comfy-Org/ComfyUI/pull/17172 で @kijai による実装 * 【パートナーノード】APIノードにおいて、パートナーノードのサインイントークンを更新:https://github.com/Comfy-Org/ComfyUI/pull/16943 で @dante01yoon による実装 * 【パートナーノード】feat(HeyGen):HeyGen Voice の即時クローンおよびテキスト読み上げ機能を追加:https://github.com/Comfy-Org/ComfyUI/pull/17043 で @bigcat88 による実装 * 【パートナーノード】feat(ClarityAI):Crystal Video Upscaler ノードを追加:https://github.com/Comfy-Org/ComfyUI/pull/17192 で @bigcat88 による実装 * 【パートナーノード】feat(BFL):FLUX 3 Video ノードに 2K/4K 解像度を追加:https://github.com/Comfy-Org/ComfyUI/pull/17200 で @bigcat88 による実装 * MOSS-image をサポート

経緯と関連報道

KimiがK3.1 Proを発表、容量増加と価格引き下げでOpus 5.5に挑む

著者|宇航猿 編集|靖宇 10月23日午前、Kimi公式はXとビデオ番号で24秒の動画を公開した。映像にはレトロな雰囲気の古いパソコンが映り、画面にはKimi Codeが起動し、端末にはThree.jsのコードが一行ずつ表示され、複雑な3Dシーンが生成されていく様子が映っていた。目ざといネットユーザーはすぐに左上隅のモデル欄で答えを見つけた――「Model: Kimi K3.1」だ。 Kimi公式が公開したK3.1の事前告知動画|画像出典:X @Kimi_Moonshot 古い時代の機械で、今日最先端の3Dコードを実行する――このギャップこそが、月之暗面が伝えたいメッセージそのものだった。 それから十数時間後、10月24日零時を過ぎた直後、プログラマーの日に合わせてKimi K3.1 Proが正式にリリースされ、同時に速度が2〜3倍速いHighspeed版も同時に登場した。公式は、完全なモデルの重み付けデータを11月4日までに公開すると約束している。 前世代のK3が発表されてから、すでに3か月以上が経過していた。この3か月間、月之暗面が経験したことは、多くの企業が1年で経験する以上のものだった。 01 「量は増やしても価格は変えない」の0.1 まず、K3.1 Proとは何かを明確にしておこう。これはまったく新しいモデルではない。月之暗面は明確に、K3.1 ProはK3の後学習版であり、基盤は変わっていないと述べている――依然として総パラメータ2.8兆、活性化パラメータ1,040億の混合エキスパートアーキテクチャ、文脈ウィンドウは100万トークン、画像および動画入力にもネイティブに対応している。 変わったのは後学習の部分だ。公式によれば、「大幅に増強された後学習用の計算能力」を投入し、数百の下流分野で大規模な共同強化学習を実施したという。そのため、強化学習フレームワーク、サンドボックスインフラ、長文脈推論といった基盤技術を一から再構築したのだ。つまり、同じ脳が、仕事のやり方を改めて“教え直された”ということになる。 その効果はランキングで明らかだ。プログラミングAIを評価するTerminal-Bench 4.0において、K3.1 Proは65.7%を獲得し、GPT-6 Astraの58.2%やClaude Opusの66.4%をわずか1ポイント弱下回る結果となった。前世代のK3は

経緯と関連報道

SyncVid:同期ビデオ生成のための世界不変拡散モデル

arXiv:2610.31765v1 発表タイプ:新規 要旨:単一の参照ビデオから動的シーンの複数の映像を生成するには、視点間で観測された内容と未観測の内容を一貫して合成する必要があります。既存のビデオ拡散におけるカメラ制御手法は、通常、カメラ埋め込み、クロスビュー注意機構、幾何学的条件付けといったアーキテクチャ上の仕組みに依存しています。しかし、これらの手法は静的なシーンコンテンツに対しては有効であっても、視点間および時間経過において一貫性が求められる細部にわたる動的ジオメトリにはしばしば対応しきれません。我々は、各2次元画像平面で独立にサンプリングを行うのではなく、ソースビデオから導かれる標準的な3次元空間においてガウスノイズの事前分布をサンプリングし、それをターゲットとなるカメラへラスタライズすることで、拡散プロセス自体を同期させます。我々のm

SyncVid: World-Equivariant Diffusion for Synchronized Video Generation
経緯と関連報道

研究では、BabyViewデータセットを用いて、子どもにおける文脈を越えた語義学習メカニズムを検証した

この論文(arXiv:2610.31842v1)は2026年10月26日に公開され、BabyViewコーパス――48人の子どもによる合計2,441時間の縦断的視点映像を収録したもの――を用いて対比的視覚言語モデルを学習し、実際の子どもの経験における「状況間学習」仮説の実現可能性を検証しています。

新闻源配图 · arXiv cs.CL

注目する理由:本研究は、大規模な自然主義的発達データを用いて、文脈間における語義学習を体系的に評価した初の事例であり、事前学習された視覚表現の重要な役割、学習信号のスパース性、ならびにモデルと子どもたちの学習経路との本質的な相違を明らかにしました。これにより、発達認知モデリングおよびAIによる言語習得研究において、方法論的な意義が示されました。

経緯と関連報道

AudioLift:マルチビュー映像生成による、音声駆動型の単一画像からフルヘッドのガウスアバターへの変換

arXiv:2610.31747v1 発表タイプ:新規 要旨:既存の3D対話型アバター手法は、主に3DMMやFLAMEを含むパラメトリック顔モデルに依存しており、そのコンパクトな動作表現により、極端な表情の合成や、頭飾りなどのアクセサリーのモデリング能力が制限されています。私たちは、パラメトリック顔モデルや個々のインスタンスに対する最適化を用いずに、音声駆動型アバター生成のための中間表現として生成されたマルチビュー映像を用いる二段階フレームワーク「AudioLift」を提案します。本フレームワークは、同期されたマルチビュー映像の生成段階と、不整合に強いガウス再構成段階を組み合わせることで、単一のポートレート画像から一貫性のあるフルヘッドの幾何形状を復元します。広範な実験により、AudioLiftはより多くの表情を捉えられる3D対話型アバターを生成することが示されています。

AudioLift: Audio-Driven Single Image to Full-Head Gaussian Avatar via Multi-view Video Generation
経緯と関連報道

KimiがK3.1 Proを発表:エンドポイントタスク能力がトップに躍進、シミュレーションによるデバッグとマルチモーダルプログラミングにより具現知能の原型を示す

Kimiは2026年10月25日にK3.1 Proモデルを発表し、Terminal-Bench 4.0のタスクテストにおいて成功率67.2%で首位に立った。また、エミュレーターのバグを自律的に修正し、物理シミュレーション、音声解析、3Dシーン構築、動画編集といった多様なタスクをこなす能力を備えており、身体拡張型知能技術の道筋を探る方向性を示している。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

注目する理由:本資料は、钛媒体が許諾して公開した実測レポートに基づいており、Artificial Analysis、Terminal-Bench 4.0 などの権威ある第三者評価データ、公式による自主テスト結果、ならびに著者による多様なシーンにおける機能検証を網羅しています。K3.1 Pro の実行性能、シミュレーションのクローズドループ、マルチモーダルプログラミングにおける実質的な進歩に焦点を当てるとともに、性能上の限界や未公表の情報(例:Flash/Ultra はまだリリースされていない)についても明示しており、事実確認および出典表示の要件に準拠しています。

経緯と関連報道

セバスチャン・ラシュカが8本のビデオコース「ゼロから推論モデルを構築する」を公開しました

セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。

注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。

経緯と関連報道

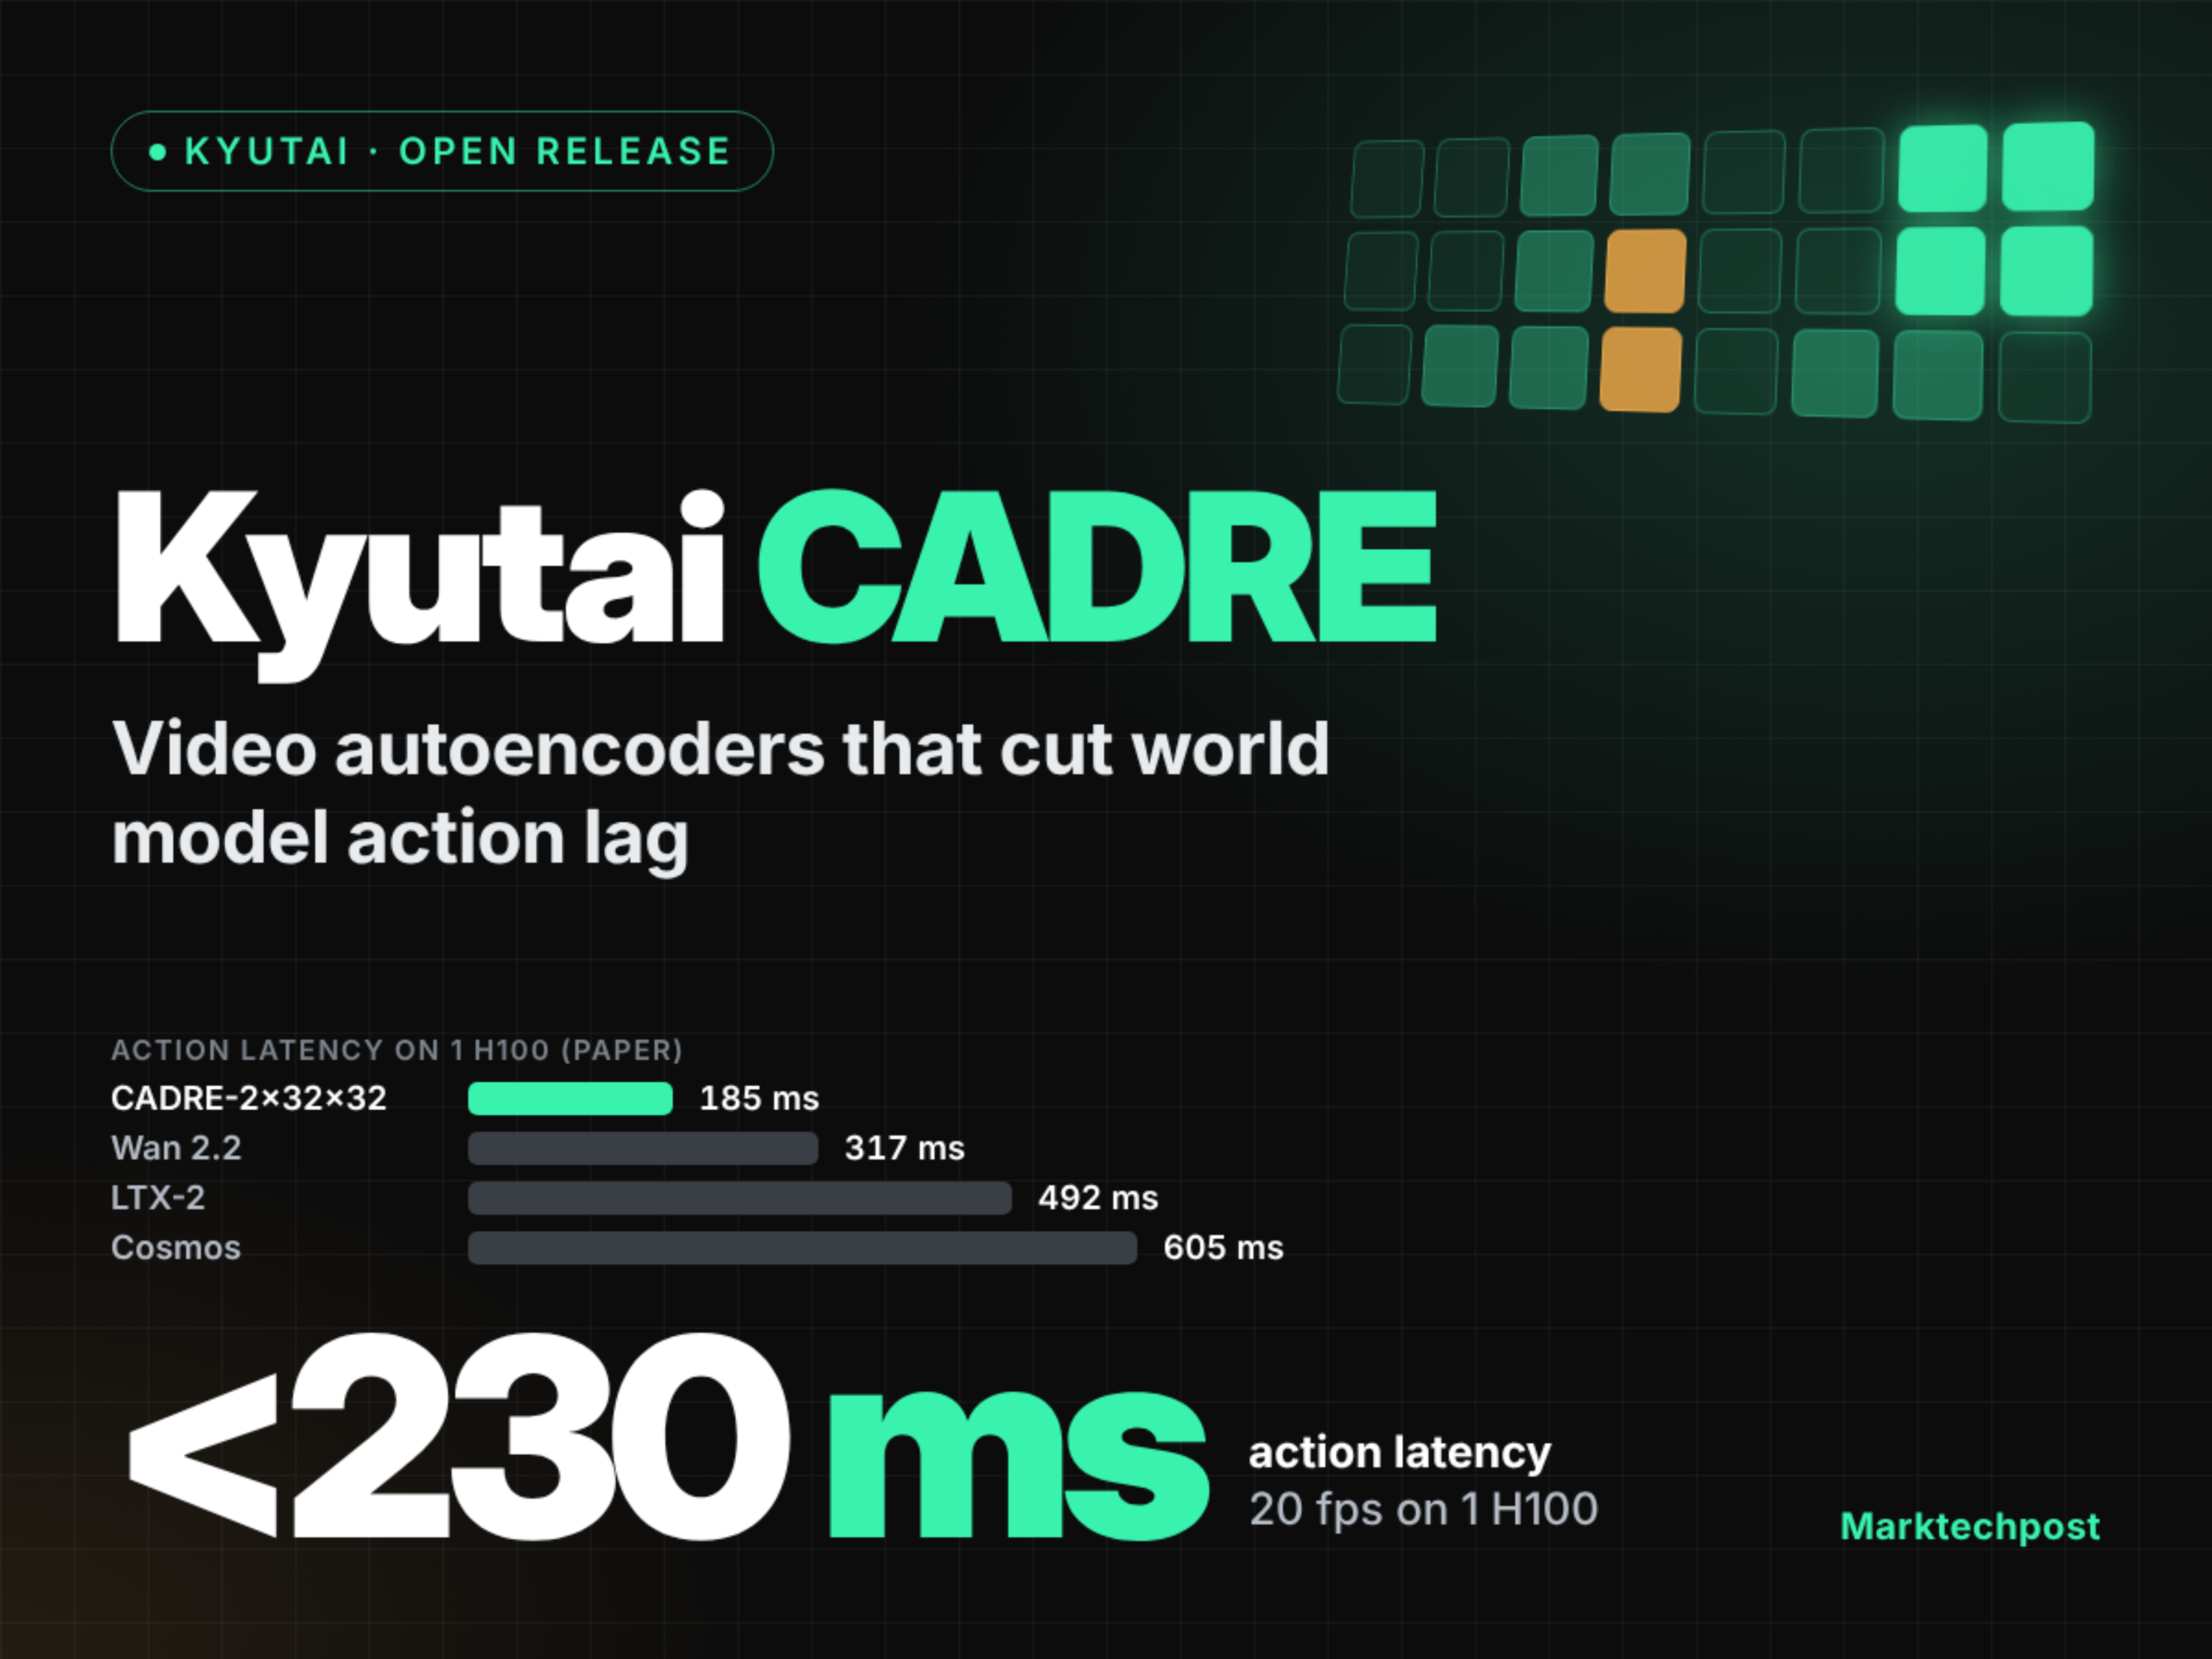
KyutaiがCADREビデオ自己符号化器ファミリーを発表:対話型世界モデル向けで、エンドツーエンドの動作遅延を230ミリ秒以下に抑えます

Kyutaiは2026年10月23日、世界モデルにおける動作遅延の低減を目的とした、7つのオープンソース因果拡散型ビデオ自己符号化器からなるモデルファミリー「CADRE」を公開しました。単一のH100 GPU上で実測した反応遅延は最低185 ms、推論フレームレートは23.4 fpsに達し、シーンFVD指標は162.6まで低下しました(Wan 2.2では599.7)。ただし、ロボット操作タスクにおける動作追従率(ARR)は、Wan 2.2およびCosmosに比べてやや劣る結果となっています。

Kyutai CADRE: Video Autoencoders That Cut World Model Lag Below 230 ms
経緯と関連報道

NVIDIAのCEOがMicroduckロボットの予約販売開始を披露し、注文数は2万台を超えた

GTCベルリン大会において、NVIDIAのCEOであるジェンスン・フアン氏は、Pollen Roboticsが開発し、現在はHugging Face(NVIDIAに買収済み)傘下にあるMicroduckロボットをデモンストレーションしました。このオープンソースのロボットは、音声コマンドにより歩行、座る、仮眠、後方宙返りなどの動作を実行できます。動画が話題になると、翌日には予約販売数が2万台を突破し、クリスマスシーズンの人気おもちゃとなる見込みです。これらのロボットはNVIDIAの技術スタックを基に訓練されており、ユーザーによるカスタム学習と新たなスキルの共有をサポートしています。

注目する理由:本情報は、提供されたTechCrunchの記事および事実リストに基づいて生成されています。資料によれば、MicroduckはPollen Roboticsによって製造され、同社は2025年にHugging Faceに買収されました。また、NVIDIAは同年9月にHugging Faceを買収しています。文中で言及されている予約販売のデータ、機能説明、納期については、いずれも資料から直接引用されており、外部からの追加情報は一切含まれていません。

経緯と関連報道

DE STAAT - FREEDOM(公式ミュージックビデオ)

DE STAAT - FREEDOM(公式ミュージックビデオ) さて、これは私にとって初めての経験です……オランダのオルタナティブロックバンドDe Staatによるこの新しいミュージックビデオの00:44あたりで、ビジュアルエフェクトはFake it or Leave itのマティース・フローテン氏が担当しています。Hacker Newsのflir経由 タグ:音楽、AI、生成AI、自転車に乗るペリカン

経緯と関連報道

Switch 2が古いゲームとAIを用いて脱獄に成功し、Modderが『Mario Kart World』のカスタムキャラクターを披露

The Vergeの報道によると、著名なModderであるSammy Hajhamid(ネット名:pepsipu)は、Nintendo Switch 2の脱獄に成功したと発表しました。彼のツール「ns2jb」はOpenAI Codexの支援を受けて開発され、古いゲームを利用して脆弱性を引き起こしています。デモ動画では、『Mario Kart World』がシナモロールや赤い怒りの鳥、ピーター・グリフィン、Minecraftのスティーブなど、非公式キャラクターを含む改造版で動作している様子が確認されています。

経緯と関連報道

パナッシュ — モバイル向けベル・エポック時代のRTS

パナッシュ — モバイル向けベル・エポック時代のRTS これは実に嬉しいですね。昨日、Apache 2.0ライセンスのもとで『Battle Drones』をリリースしたところ、すでにフランス語版のフォークが登場し、ゲームの背景をスチームパンク風の1900年代フランスに変更し、アニメーション付きのオープニングも追加されています! パナッシュは、モバイルおよびブラウザ向けのリアルタイムストラテジーゲームで、ベル・エポック期のフランス(1900年頃)を舞台としています。飛行船、蒸気式装甲車、クレウゾー製の装甲艦、軍帽をかぶった自動人形、歩く要塞ガルガンチュア――そして、まさに「パナッシュ」あふれる世界が広がります。 こちらからパナッシュをプレイできます。新しいオープニング映像を体験するだけでも、リンクをクリックする価値があります。現時点では、ゲームプレイの変更というよりは、主にビジュアル面でのアップデートにとどまっています。音楽にもフランスらしいアレンジが施されています。新しいスチームパンク調のモデルはとてもカッコイイですね! こちらのページには…

経緯と関連報道

ウクライナがドローンを用いた負傷者の救出を初めて実戦で運用し、戦場での救急医療は新たな段階へと踏み出した

ウクライナ軍は前線で、世界的にも稀な大型の六ローター型ドローンによる負傷者空輸作戦を成功させ、長らく試験段階にあった無人化された戦場における医療後送の概念を実証した。作戦の発生時刻および地点は公表されていないが、関連映像は2026年10月19日にウクライナ軍の公式アカウントにより公開された。

経緯と関連報道

PyTorch 2.15 は MPS を正式にサポート:FP8、MoE の高速化、および Metal カーネルが全面的にアップグレードされました

PyTorch 2.15 は、Apple Silicon Mac に重大な MPS バックエンドのアップグレードをもたらし、macOS 上で初めて FP8 テンソル演算をネイティブにサポートします。また、MoE モデルのデコード速度が 5~6.5 倍に向上し、ビデオ VAE のデコードにおけるピークメモリ使用量は 270 GiB から 8 GiB へと大幅に削減され、さらに多数のオペレーターが MPSGraph から専用の Metal カーネルへ移行されました。

経緯と関連報道

NVIDIAがCosmos3-H-Dreamsを発表:実際の胆嚢摘出術の臨床動画に基づく初のリアルタイム生成型外科手術シミュレーター

NVIDIAは、臨床における胆嚢摘出術(cholecystectomy)の動画およびロボットの運動学データを用いて訓練された、初のリアルタイム生成型手術シミュレーター「Cosmos3-H-Dreams」を発表しました。このシミュレーターは、Versius手術ロボットプラットフォームから取得した動作に基づいた対話型で低遅延の視覚シミュレーションをサポートし、単一のRTX PRO 6000 GPU上で動作します。

経緯と関連報道