본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

오늘의 추천

원문 출처를 바탕으로 주목할 AI 변화를 이해합니다.

발행 시간순

GPT-7은 2027년까지 신체 기반 지능 문제를 완전히 해결할 수 있을 것으로 보이며, 외부 모델이 로봇 개발 패러다임을 가속화하고 재편하고 있다.

타이미디어의 10월 26일 보도에 따르면, 유수커의 공동창업자 왕싱싱은 2026년 10월 12일, 내년에 출시될 GPT‑7이 “신체 기반 지능 문제를 단번에 해결할 수 있을 것”이라고 밝혔다. 이는 그가 지난 8월에 제시한 ‘빠르면 2~3년’이라는 예측보다 훨씬 앞당겨진 판단이다. 같은 시기, Artificial Analysis, RoboDojo 등 기관들의 실증 결과에 따르면, GPT‑6 Astra와 같은 범용 대형 모델이 시뮬레이션과 실제 로봇 작업에서 전용 전략을 거의 따라잡거나 오히려 추월하는 수준에 도달했지만, 실행 타이밍, 호출 비용 및 신뢰성 측면에서는 여전히 뚜렷한 한계가 남아 있다. 또한 Physical Intelligence 등 기업들은 API 서비스를 개방해, 로봇 지능이 자체 개발 중심의 고정 자산 방식에서 필요에 따라 구매하는 기술 서비스로 전환되는 추세를 촉진하고 있다.

추천 이유:자료는 다중 출처에서 검증 가능한 최근 사건들을 기반으로 합니다: 왕싱싱의 공개 발언(상하이증권보, 2026-10-12), AA-Robotics v0.1 실기기 평가(2026-10-14), RoboDojo 시뮬레이션 순위(2026-09), PI API 개방(2026-10-13) 및 Figure, 은하유니버셜, 위수 등 기업들과의 협력 진행 상황(모두 2026년 10월 중 발생) 등이며, 모든 시점은 현재 시스템 시간(2026-10-26)을 넘지 않습니다. 또한 출처가 명확하고 서로 간에 상호 검증이 이루어져 있어 강력한 시의성과 사실적 근거를 갖추고 있습니다.

진행 상황 및 관련 보도

중국 최초의 AI 극장용 영화 ‘삼성퇴: 미래의 과거사’ 개봉: 기술적 이정표와 시장의 냉대가 공존

2026년 10월 23일, 보나필름이 제작한 ‘삼성퇴: 미래의 과거사’는 국내 최초로 상영허가를 취득하고, 전 과정에서 AI의 참여를 바탕으로 제작되어 상업 극장에서 정식으로 개봉한 장편 영화로서 전국 극장에 상영됐다. 이 작품은 전편에 디지털 캐릭터만 등장하며 실사 배우는 출연하지 않았고, 제작비는 수천만 위안에 달했지만 첫 주말 박스오피스 수익은 약 118만 위안에 그쳤으며, 상영 편수와 관객 점유율도 저조해, 서사적 수용도와 산업화 적용 간의 현실적 괴리를 여실히 드러냈다.

추천 이유:해당 보도는 타이메디아가 2026년 10월 26일에 발표한 심층 기사를 바탕으로 하며, 영화의 기술적 정체성(최초의 AI 극장용 장편 영화), 제작 현황(120만 장의 원본 이미지, 600:1의 폐기 비율, 프레임별 수작업 처리), 산업적 의의(심사 및 배급 전 과정의 흐름 구축)와 시장 반응(낮은 흥행 성과, 관람료 논란, 관객의 관망 태도)을 종합적으로 담고 있습니다. 정보 요소가 완전하고 출처가 명확하며 시의성이 높으며, 자료의 사실적 한계를 넘어서지 않았습니다.

진행 상황 및 관련 보도

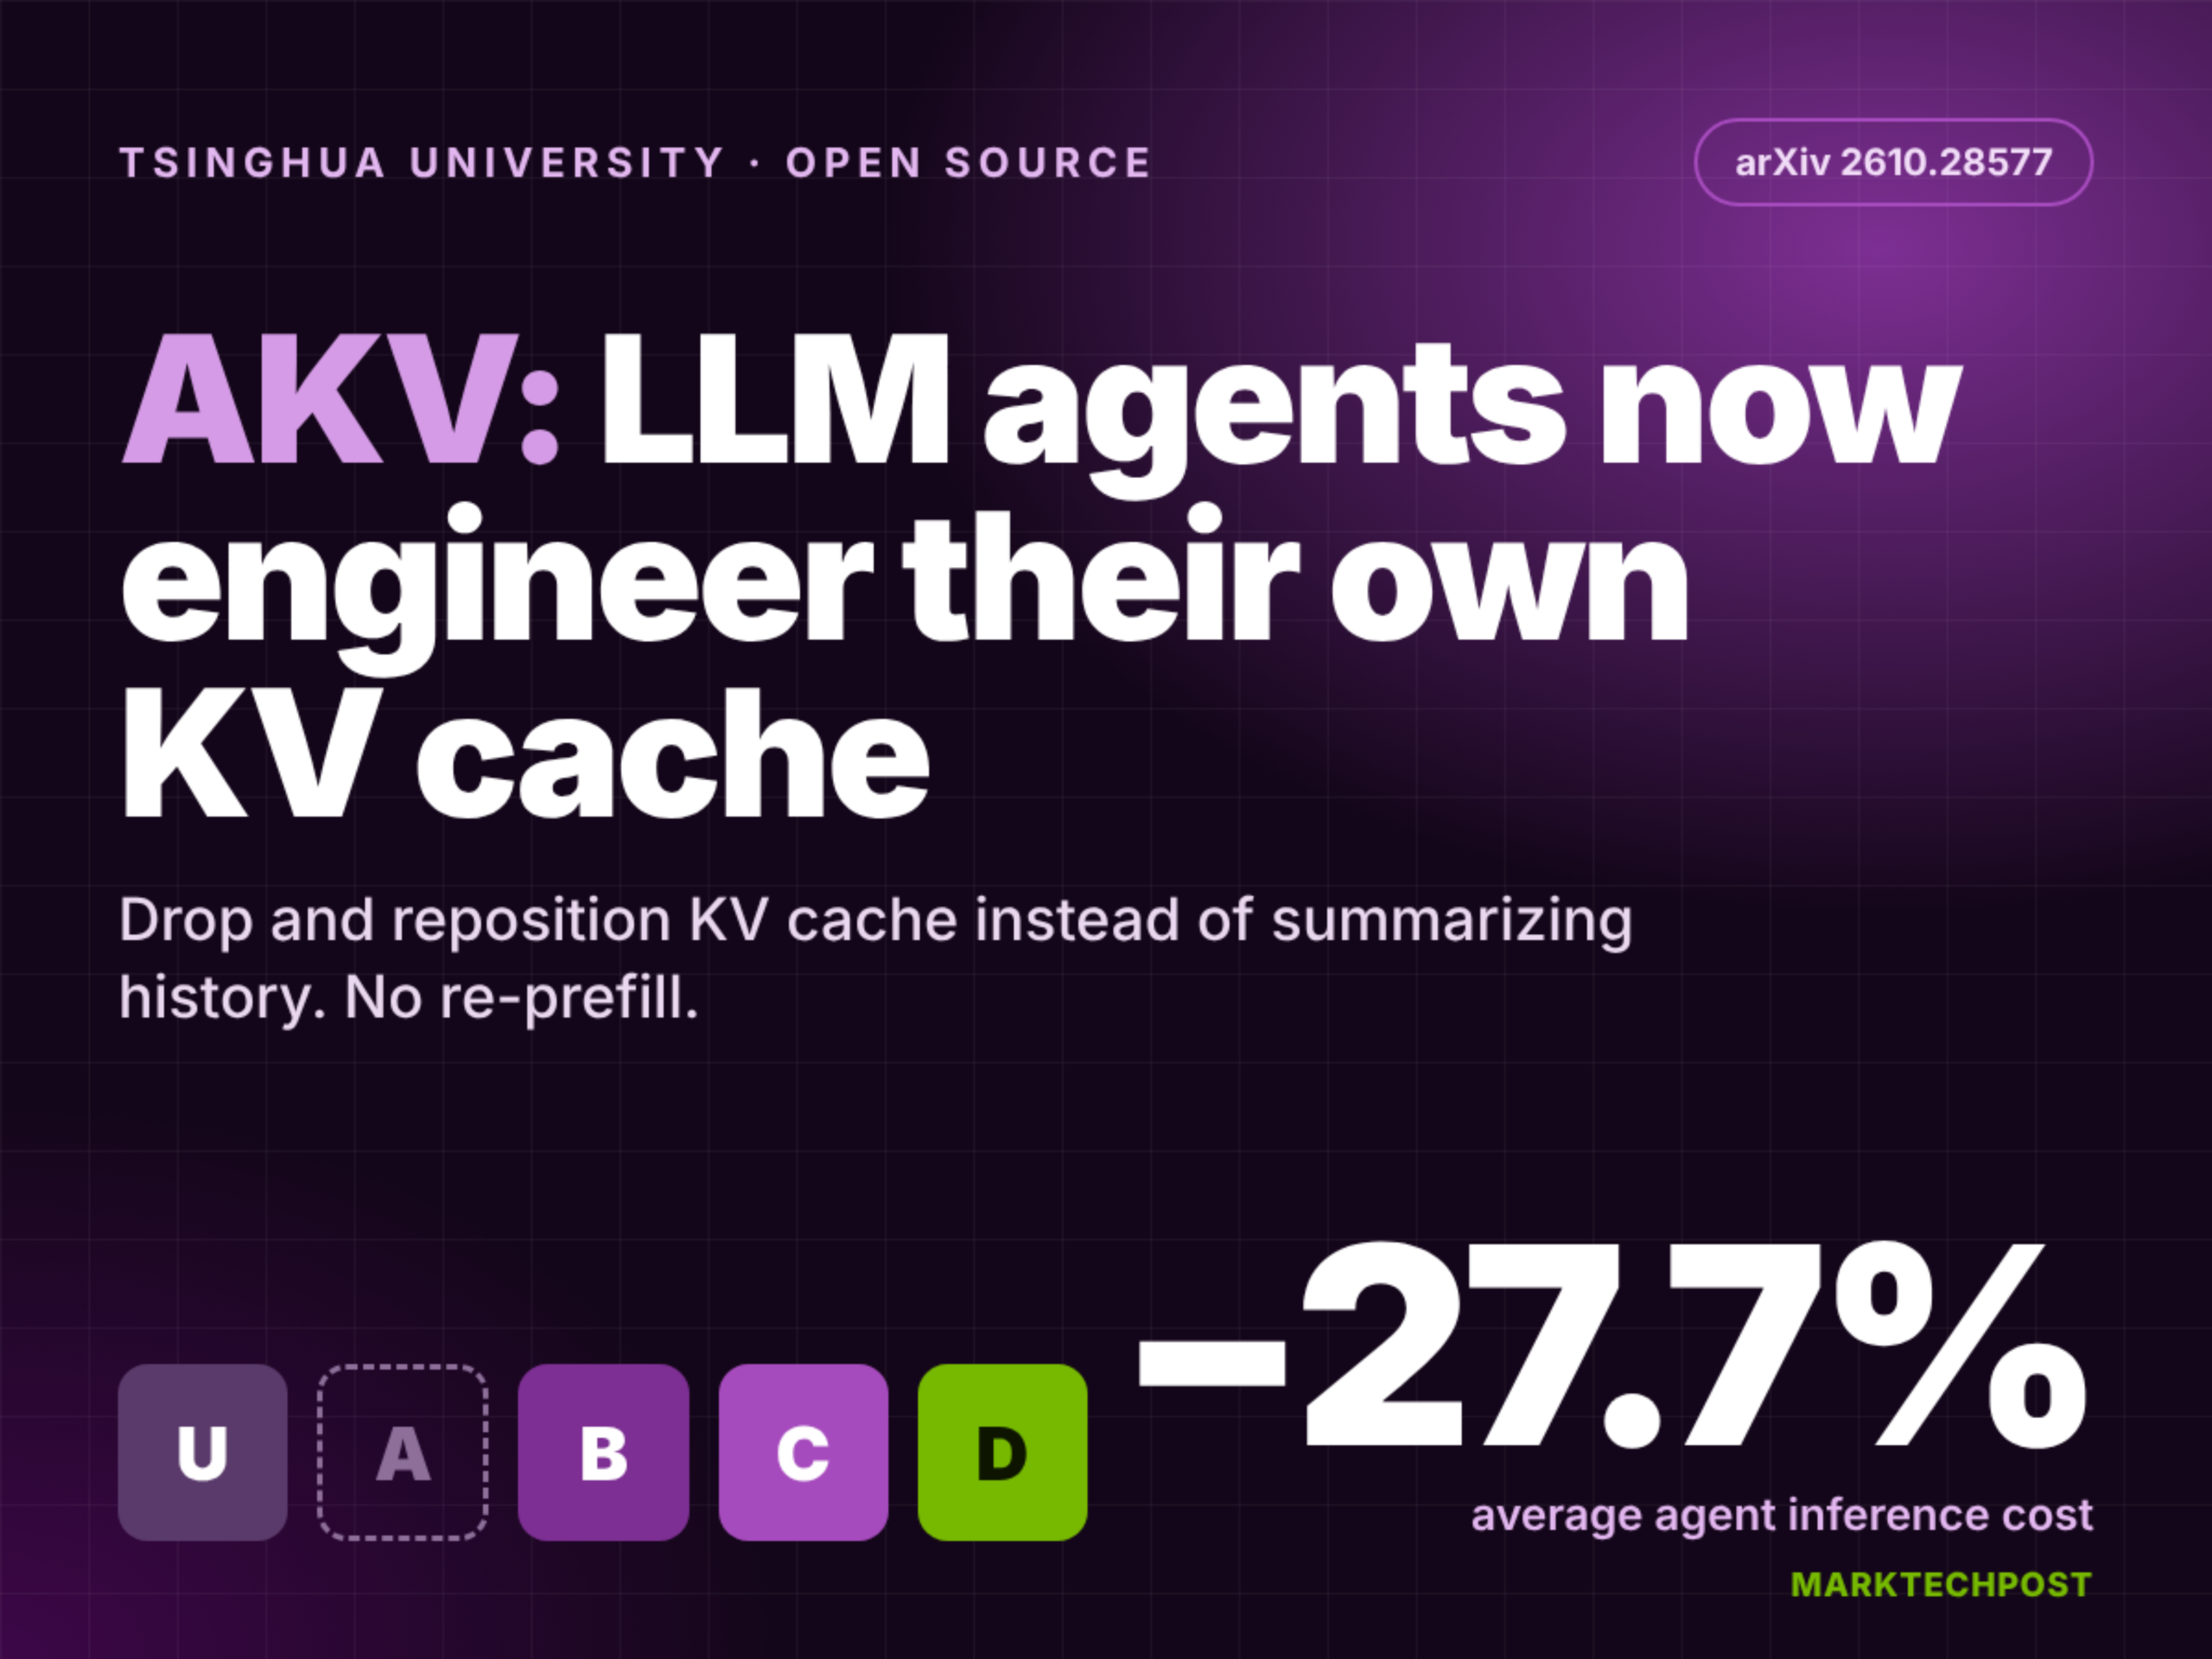
칭화대학교와 홍콩중문대학교가 공동으로 오픈소스 AKV를 출시했습니다: LLM 에이전트를 위한 KV 캐시 엔지니어링 서비스 시스템

칭화대학교와 홍콩중문대학교의 연구진은 2026년 10월 26일, SGLang 기반으로 구축된 대규모 언어모델(LLM) 에이전트 전용 KV 캐시 엔지니어링 서버인 AKV를 오픈소스로 공개했습니다. 이 시스템은 기존의 텍스트 히스토리 요약 방식이 아닌, 에이전트가 스스로 KV 캐시를 적극적으로 버리고 재배치하도록 함으로써, 4개의 에이전트 벤치마크에서 추론 비용을 평균 27.7% 절감하고, 과제 평균 점수를 1.7점 상승시켰습니다. 해당 코드는 Apache-2.0 라이선스를 적용했으며, 현재 Qwen, GPT-OSS-120B, MiniMax-M2.7 등의 모델을 지원합니다.

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

추천 이유:이 성과는 LLM 에이전트의 효율적 추론을 위한 새로운 패러다임을 제시합니다. 텍스트 절단이나 요약에 의존하는 ‘컨텍스트 엔지니어링’과 달리, AKV는 KV 캐시 상태를 직접 조작하여 중복 프리필을 방지함으로써 장거리 상호작용에서의 KV 부하를 크게 완화합니다. 실제 실험 결과, 높은 동시성 환경에서 P95 지연 시간이 229.9초에서 30.6초로 감소하여 명확한 엔지니어링 가치와 재현 가능성을 입증했습니다. 해당 정보는 MarkTechPost가 발표한 권위 있는 기술 보고서에 근거하며, 게시일시(2026-10-26T07:56:45Z)가 현재 시각과 일치해 최신 공개된 진행 상황임을 나타냅니다.

진행 상황 및 관련 보도

국산 대규모 언어 모델들이 소비자 하드웨어 시장에 집단적으로 진출하고 있다: 제추성신과 알리천문이 같은 날 AI 스마트폰 및 안경을 출시했다.

2026년 10월 13일, 제이추신청은 알리천문과 동시에 AI 스마트폰, AI 안경 및 이어폰 등 소비자용 하드웨어 제품을 출시하며, 이는 국산 대형 모델 경쟁의 중점이 모델 성능 지표에서 단말기 진입로 확보로 전환되었음을 의미한다. 같은 시기, 틱톡의 더우바오와 샤오미 등도 AI 원생 하드웨어 생태계 구축을 가속화하고 있다.

추천 이유:본 자료는 티에이미디어가 공식적으로 제공한 산업 심층 보도로, 출처가 명확하며(사쿠 재경/티에이미디어), 구체적인 게시일자(2026-10-26)와 다수의 업체 동향, 검증 가능한 데이터(예: 대규모 모델 1,509개, 3,999위안의 가격 책정, 징둥의 예약 건수 36만 건 등)를 포함하고 있습니다. 또한 모든 사실은 해당 자료에 명시된 내용과 일치하며, 외부적 추론이나 허구는 전혀 포함되어 있지 않습니다.

진행 상황 및 관련 보도

AI 안경 산업의 폭발적 성장 속 전반적인 가치사슬의 피로 상태에 대한 고민|타이미디어 심층 보도

2026년 상반기 전 세계 AI 안경 출하량은 420만 대에 달해 전년 동기 대비 127% 증가했으며, 중국 브랜드는 약 400개에 이르고 신제품 출시 밀도는 평균 사흘에 한 제품꼴에 달합니다. 그러나 업계는 높은 반품률(60~70%)과 단말기의 총이익률이 20%를 조금 넘는 수준에 머무는 등 구조적 문제에 직면해 있으며, 자금 조달 역시 공급망 쪽으로 편중되어(70%가 상류부문에 집중) 주요 브랜드들이 IPO를 잇따라 추진하며 생존을 도모하는 등 전반적인 자원 소진 현상이 심각한 상황입니다.

추천 이유:이 보도는 일선 공장, 창업가, 공급망 업체 및 투자자 등 다양한 출처의 정보를 바탕으로 하며, AI 안경 산업이 겉으로는 호황을 누리고 있는 듯하지만 그 이면에 존재하는 현실적 어려움을 상호 검증하고 있다. 데이터는 Omdia, 로투테크 등 제3자 기관에서 제공한 것이며, 시점(2026년 618, 4월 XREAL의 IPO 신청 등)과 자료 게재일시(2026년 10월 26일)가 일치하고, 인물은 가명으로 표기되었으며 출처는 타이미디어의 허가를 받아 전재된 것임이 명시되어 있어 시의성과 출처 추적 가능성을 충족한다.

진행 상황 및 관련 보도

SAGE 벤치마크와 GAR 프레임워크 발표: 다중 모달 의미 정합성 평가 촉진

2026년 10월 26일, arXiv은 논문 arXiv:2610.31838v1을 발표하여 Sense-Aligned Grounding Evaluation(SAGE)를 제안했습니다. 이는 통합된 10개의 후보 이미지 선택 기준이며, 명사, 동사 및 엔터티 중심의 다중모달 그라운딩 평가를 위한 학습 독립형 Gloss-Augmented Reasoning(GAR) 프레임워크와 함께 제공됩니다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 최초로 VWSD, VerSe 및 WikiDiverse 세 가지 유형의 과제를 용어 중심의 지상 검증 프로토콜로 통합하고, 혼동을 유발하는 어려운 음성 샘플과 문맥 교환 진단 메커니즘을 도입하며, 정의 강화와 제약 기반 추론의 상호작용이 Hits@1 지표를 크게 향상시킬 수 있음을 실증적으로 입증했습니다(65.90→71.22). 이를 통해 다모달 의미 정렬에 대해 보다 세밀하고 해석 가능한 평가의 새로운 패러다임을 제공합니다.

진행 상황 및 관련 보도

연구는 자폐 스펙트럼 장애와 비자폐 스펙트럼 장애를 가진 개인 간의 2인 대화에서 성공적 인지 여부를 예측하는 다중모달 접근법을 제안한다.

arXiv에 게재된 새로운 연구(번호 2610.31682v1)는 언어 운동, 얼굴 표정, 음성 리듬 및 대화 차례 전환 등 다중 모달 특성을 활용하여, 자폐 스펙트럼 장애와 비자폐 스펙트럼 장애 참가자가 포함된 세 개의 자발적 이인 상호작용 데이터셋에서 참가자 본인이 인식하는 대화 성공 수준을 예측합니다.

Multi modal perceived conversation success prediction for spontaneous autistic and non-autistic dyadic interactions

추천 이유:이 연구는 기존의 진단 분류나 단일 모달 분석에 국한되던 한계를 극복하고, 최초로 상호 보완적인 다중 모달 행동 지표를 체계적으로 통합하여 ‘인지된 대화 성공’이라는 사회적 소통의 핵심 차원을 모델링함으로써, 신경다양성 인구의 의사소통 지원 기술을 향상시키기 위한 새로운 방법론적 근거를 제시하였다. 해당 논문은 이미 공개되었으며, 타임스탬프는 현재 시스템 시간과 일치하여 최신 학술 성과에 해당한다.

진행 상황 및 관련 보도

연구진이 라틴어 전용 언어 모델 LAMB와 두 개의 새로운 말뭉치인 Acervus 및 Corpus Trinum을 발표했습니다.

2026년 10월 26일, arXiv는 논문 arXiv:2610.31723v1을 발표하여 라틴어 전용 엔코더인 Latin Modern BERT(LAMB)를 제안했다. 이 모델은 ModernBERT 아키텍처를 기반으로 하며, 두 단계의 사전훈련 과정을 거쳤고, 740억 개가 넘는 라틴어 토큰과 새로운 형태론적 감지 마스크 전략을 사용한다. 동시에 두 개의 완전히 새로운 라틴어 코퍼스도 공개했는데, 하나는 240억 개의 토큰을 포함하는 Acervus로, 여기에는 ByT5를 통해 복구된 OCR 오류 텍스트 76만 건이 포함된다. 또 다른 하나는 최초로 인공적으로 구축된 라틴어 의미 트리플 데이터셋 Corpus Trinum으로, 강/약 트리플이 1억 개를 상회한다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 고전 언어 NLP의 기초 자원 부족을 해소하고, 라틴어의 의미 이해를 위한 대규모 사전훈련 모델과 이를 지원하는 평가 벤치마크를 최초로 체계적으로 구축했으며, 엄밀한 실험을 통해 LAMB가 17개 하위 과제 중 16개에서 우위를 보임을 입증함으로써 명확한 기술적 기여와 재현 가능성을 확보했습니다. 모든 결론은 arXiv 논문 초록 및 사실 추출 내용에 엄격히 부합하며, 외부 정보는 전혀 도입되지 않았습니다.

진행 상황 및 관련 보도

새로운 연구에 따르면, 강화학습에서 기존의 크리틱은 대규모 언어 모델의 신뢰도 추정기로 그대로 재사용할 수 있다.

2026년 10월 26일 arXiv에 게재된(번호 2610.31820v1) 한 편의 AI 연구 논문은, 가치 기반 강화학습(value-based RL)으로 학습된 대형 언어 모델(LLMs)의 경우, 기존의 크리틱 모듈이 별도의 학습이나 데이터 없이도 높은 정확도와 높은 교정성을 갖춘 신뢰도 추정기로 활용될 수 있음을 보여준다고 지적했다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 신뢰도 추정과 강화학습에서의 크리틱 학습 간의 수학적 본질적 동등성을 밝혀냈으며(정확성 결과 정의 하에), 10여 개 분야(수학, 코드 작성, 도구 호출, 일반 추론)에 걸친 실증을 통해 크리틱 재사용의 효과성과 일반화 능력을 검증하였다. 이러한 성과는 LLM의 신뢰할 수 있는 배포 문턱을 낮추는 데 직접적인 엔지니어링 가치를 지닌다.

진행 상황 및 관련 보도

SpecMem은 실시간 도구 호출 메모리 관리 메커니즘을 제안하여 에이전트의 응답 속도를 향상시킵니다.

arXiv는 2026년 10월 26일, “SPECMEM: 실시간 메모리 관리를 통한 에이전트 기반 도구 호출 가속”이라는 제목의 사전 인쇄 논문(번호 2610.31840v1)을 발표하며, 세션 간에 온라인으로 업데이트되는 사용자 수준의 도구 호출 메모리 관리를 통해 도구 호출 지연을 크게 줄이는 새로운 시스템인 SpecMem을 제안했습니다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 현재 도구 호출 에이전트가 배포 과정에서 자회귀 디코딩으로 인해 발생하는 높은 지연 문제를 해결하기 위해, 검증 가능한 쓰기 반영, LRU 제거, 부작용 게이팅 등 핵심 기술을 제안하고, 다중 사용자·다중 세션의 실제 쿼리 흐름에서 그 효과성을 검증했습니다(최대 1.74배의 실측 가속, 평균 수신 토큰 27% 증가). 이는 AI 시스템 엔지니어링 분야에서 중요한 진전입니다.

진행 상황 및 관련 보도

연구는 그래프 추론 기반의 퍼지 인식 구조화 생성이라는 새로운 패러다임을 제안한다.

2026년 10월 26일 arXiv에 게재된 논문(번호 2610.31681v1)은 전통적인 구조화된 생성 방식이 입력을 출력으로 매핑하는 과정을 결정론적 단사 사상으로 간주함으로써, 자연어가 본래 지니는 다중 의미의 유효성과 충돌한다고 지적한다. 저자들은 이를 ‘모호성 인지 추론 문제’로 재구성하고, 그래프 표현을 기반으로 한 후보 구조 공간을 구성한 뒤 그래프 기반 추론을 수행함으로써, 의미의 모호성을 유지하면서도 출력의 안정성과 로버스트성을 향상시킨다.

Rethinking Structured Generation: Can Graph-Based Reasoning Resolve Ambiguity?

추천 이유:이 연구는 구조적 생성에서 오랫동안 간과되어 온 모호성 모델링의 결함을 정면으로 지적하고, 검증 가능한 기술적 경로(다중 유효 학습 + 그래프 구조 후보 공간 + 의미 정합 및 관계 일관성 추론)를 제시하며, 표준 벤치마크에서 정확도, 안정성 및 로버스트성의 체계적인 향상을 보고함으로써 방법론적 혁신성과 실무 지침으로서의 가치를 갖습니다.

진행 상황 및 관련 보도

arXiv의 새로운 논문은 증거 검증과 가중치 업데이트가 필요 없는 프롬프트 수정을 지원하는, 추적 가능한 다모달 감정 추론 에이전트 프레임워크를 제안합니다.

2026년 10월 26일, arXiv는 사전인쇄 논문(번호 2610.31685v1)을 발표하며, 동결된 대규모 모델 기반의 추적 가능한 다중모달 감정 추론 지능체 아키텍처를 제안했습니다. 이 아키텍처는 모달별 전용 인지 지능체, 통합 지능체, MLLM 비판자 및 증거 검증 단계를 통해 오류 귀속과 프롬프트 공간의 자율적 최적화를 구현하며, MER2025 데이터셋에서 여러 개방형 다중모달 대규모 모델(2B–38B 파라미터)의 감정 인식 F-스코어를 0.6~2.2점 향상시켰습니다.

An Agentic Approach with Evidence-Grounded Verification for Multimodal Emotion Reasoning in Conversation

추천 이유:이 연구는 현재 다중 모달 감정 추론 시스템에서 명령 미세조정 비용의 높음과 에이전트 파이프라인의 디버깅 불가능성 간의 모순을 해결하기 위해, 증거 인용, 확실성 검증, 실패 귀인 및 타깃형 프롬프트 수정을 통합한 최초의 전 과정 설명 가능한 프레임워크를 제안한다. 모든 개선 사항은 모델 가중치를 변경하지 않으며, 네 가지 서로 다른 규모의 오픈소스 MLLM에서 실증적으로 효과를 입증하여 방법론적 혁신성과 공학적 실용성을 갖추고 있다.

진행 상황 및 관련 보도

쿼리의 추상성 수준이 고전 아랍 시어 검색 성능을 좌우한다: BM25와 밀집 부호화기의 성능은 쿼리의 추상도에 따라 크게 달라진다

2026년 10월 26일 arXiv에 게재된 최신 연구(arXiv:2610.31821v1)에 따르면, 고전 아랍 시 검색 과제에서 사용자의 구절 기억 잔존 정도(예: 반행을 기억하는지 여부)가 모델의 성능보다 검색 성능을 결정하는 데 훨씬 더 중요한 요소로 작용한다. BM25는 ‘혀끝 효과’ 유형의 쿼리에서는 8B 파라미터의 SOTA 모델을 포함한 모든 밀집 부호화기보다 우수했으나, 추상적 쿼리에서는 크게 뒤처졌다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 이중 코퍼스, 삼중 인덱싱 모드 및 이중 평가 프로토콜을 활용한 체계적인 벤치마크를 통해, 질의 추상화 수준이 다양한 검색 패러다임(어휘적 vs. 밀도 기반)에 미치는 지배적 영향을 최초로 정량적으로 규명하였으며, 인간 라벨러와 오픈소스 가중치 모델을 통한 이중 검증을 거쳐, 그 결론은 방법론적 보편성과 실증적 견고성을 갖추고 있다.

진행 상황 및 관련 보도

연구는 BabyView 데이터셋을 활용하여 아동의 상황 간 어휘 의미 학습 메커니즘을 검증합니다.

이 논문(arXiv:2610.31842v1)은 2026년 10월 26일에 발표되었으며, BabyView 코퍼스—48명의 아동이 참여한 총 2,441시간 분량의 종단적 1인칭 시점 영상 데이터를 포함—를 기반으로 대비형 비전-언어 모델을 학습하여, ‘상황 간 학습’ 가설이 실제 아동의 경험에서 얼마나 실현 가능한지 검증하였다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 대규모 자연주의 발달 데이터를 바탕으로 상황 간 어휘 의미 학습을 체계적으로 평가한 최초의 사례로, 사전 훈련된 시각적 표현의 핵심적 역할과 학습 신호의 희소성, 그리고 모델과 아동의 학습 경로 간의 본질적 차이를 규명함으로써, 발달 인지 모델링 및 AI 언어 습득 연구에 방법론적 함의를 제시한다.

진행 상황 및 관련 보도

연구는 대형 언어 모델 시대를 위한 지식 그래프 품질 평가 프레임워크를 제안한다.

2026년 10월 26일 arXiv에 게재된 논문(번호 2610.31684v1)은 데이터, 정보, 연관 데이터 및 지식 그래프(KG)의 품질 평가 연구를 체계적으로 정리하고, 대규모 언어 모델(LLM)이 추론의 근거로 KG에 의존하는 새로운 시나리오를 고려하여, 24개의 품질 차원과 다양한 품질 지표를 포함하는 범용적이고 맞춤형 지식 그래프 품질 평가 프레임워크를 제안한다.

Knowledge Graphs Quality Assessment in the Era of LLMs: A Conceptual Framework

추천 이유:이 논문은 현재 LLM과 KG의 심층적 융합이 이루어지는 배경 속에서 지식의 신뢰성이라는 핵심 문제를 정면으로 다루며, 다분야 품질 평가 이론을 최초로 통합하여 포괄적이면서 실제 응용에 적합한 평가 체계를 구축하였다. 또한 논문의 게재일자(2026-10-26)는 현재 날짜와 일치하여 최신 학술 성과에 해당하며, 권위 있는 사전출판 플랫폼인 arXiv에 게재되어 출처가 명확하고 학술적 규범성을 갖추고 있다.

진행 상황 및 관련 보도

LLM 평가에서 전체 F1 점수만을 사용해 자동 채점기를 검증하는 것은 오해를 유발할 위험이 있다: 새로운 연구는 구체적인 프롬프트 차이에 맞춰 검증해야 함을 강조한다

arXiv 논문(2610.31678v1)은 대화형 대규모 언어 모델 평가에서 자동 채점 도구의 전체 정확도나 F1 점수에만 의존하면 프롬프트 특이적 오류가 가려져 프롬프트 효과에 대한 잘못된 판단을 초래할 수 있다고 지적한다. 실증 분석에 따르면, 동일한 채점 도구가 서로 다른 프롬프트에서 보이는 위양성률은 2.6%에서 33.3%로 크게 차이 나며, 겉보기로 유의미한 9.3점의 효과도 두 개의 LLM 심사 하에서는 2.3점으로 축소되고 통계적으로 유의미하지 않게 된다.

Validating the Comparison, Not Just the Scorer: Why Overall Accuracy Can Mislead in Interactive LLM Evaluation

추천 이유:이 연구는 실제 실험 데이터(6개의 모델, 180개의 가상 개체 질문, 6가지 프롬프트 조건)를 기반으로 하며, 현재 LLM 평가에서 널리 존재하는 방법론적 취약점을 밝혀냈습니다—즉, 스코어러의 전반적인 성능을 핵심 비교 과제에서의 신뢰성과 동일시하는 문제입니다. 핵심 주장(각 프롬프트를 별도로 검증하고 불확실성을 반영해야 한다는 점)은 명확한 실증적 근거와 실행 가능한 권고안을 바탕으로 하며, 발표 시점(2026년 10월 26일)과 출처의 신뢰성(arXiv 사전출판 플랫폼) 측면에서도 높은 시의성을 갖습니다.

진행 상황 및 관련 보도

연구에 따르면, 활성화 간섭은 도구 사용 모델에서 조건의 재사용을 어렵게 만드는 것으로 나타났다.

해당 논문은 2026년 10월 26일에 arXiv(번호 2610.31686)에 게재되었으며, Qwen3.5-27B 모델을 기반으로 시간 또는 권한에 따라 자격을 판단하는 도구 사용 과제에서 활성화 간섭이 ‘조건 재사용’ 능력에 미치는 영향을 체계적으로 분석하였다. 실험 결과, 간섭은 목표 선택 정확도를 유의미하게 향상시켰지만, 사실과 식별자 재조합 시나리오에서는 일반화가 실패했으며, 후보자의 자격에 대한 독립적 판단 역시 개선하지 못했다.

From Target Selection to Condition Reuse: Auditing Residual Interventions in Tool-Use Models

추천 이유:본 연구는 ‘목표 선택 제어’, ‘조건에 대한 민감한 판단’, 그리고 ‘완전한 동작의 정확성’이라는 세 가지 유형의 능력을 최초로 명확히 구분하며, 출력된 답안만을 최적화하는 것만으로는 모델이 개입에서 설정된 조건(예: 시간, 권한)을 진정으로 이해하고 이를 재사용할 수 있음을 보장하기에 충분하지 않다는 점을 지적합니다. 이는 신뢰할 수 있는 도구 호출과 통제 가능한 AI 시스템 설계에 있어 방법론적 함의를 제공합니다.

진행 상황 및 관련 보도

새로운 연구에 따르면 LLM 수학 과외 평가에는 심각한 측정 편향이 존재하며, 정확히 일치하는 점수는 성과를 거의 40%포인트나 과소평가한다.

arXiv에 2026년 10월 26일 게재된 논문 “MisconceptDialogue: Evaluation Criteria Shape Measured Success in LLM Math Tutoring”은 MISCONCEPTDIALOGUE 자동화 평가 프레임워크를 제안하며, 5,000회 이상의 대화 테스트를 바탕으로 수학 과외 모델로서 5종의 오픈소스 소규모 파라미터 LLM(7B–14B)의 성능을 평가했습니다. 연구 결과, 주류인 정확히 일치하는 점수 매기기 방식에서는 구제 성공률이 42.1%에 불과한 반면, 인공적으로 보정된 LLM 심사자의 평가는 동일한 대화에서 81.3%로 나타나, 그 차이는 39.2%p에 달했습니다. 또한 이러한 편차는 우연한 것이 아니며, 네 가지 유형의 LLM 심사자와 200개의 인공 라벨링 결과 간에는 높은 일치도(kappa 최대 0.91)가 확인되었습니다. 아울러 모델은 진단 정보(정확한/잘못된 개념)에 대한 응답에서 거의 차이를 보이지 않아, 진단 입력을 효과적으로 활용하기 어렵다는 점을 시사합니다.

MisconceptDialogue: Evaluation Criteria Shape Measured Success in LLM Math Tutoring

추천 이유:이 연구는 현재 LLM 교육 적용 평가 방법론의 핵심적 결함을 정면으로 지적한다: 단일하고 경직된 자동 채점에 의존하면 실제 능력 판단이 심각하게 왜곡될 수 있다는 점이다. 또한 대규모 시뮬레이션 실험 설계, 다수 평가자 간 수렴 검증, 그리고 진단-교육 연계의 실패에 대한 실증 분석을 통해, AI 기반 교육 평가의 표준화를 위한 중요한 경고와 재현 가능한 방법론적 기준을 제시하였다.

진행 상황 및 관련 보도

연구에서는 언어 모델의 신념 조직성을 평가하기 위한 ‘도식 일치 척도’(SCI)를 제안하였다.

2026년 10월 26일, arXiv는 논문 arXiv:2610.31683v1을 발표하여 스키마 일관성 인벤토리(SCI)를 제안했다. 이는 96개의 문항으로 구성된 강제 선택형 척도로, 페르소나에 따라 조정되는 언어 모델이 부여받은 신념이 실제로 그들의 인지를 조직화하는지, 아니면 단지 정서적 반응만을 유발하는지 검증하기 위한 것이다.

The Schema Coherence Inventory: Measuring Whether an Assigned Belief Organizes a Language Model's Cognition

추천 이유:이 연구는 언어 모델의 ‘신념 내재화 정도’에 대해 현재까지 검증 가능한 측정 방법이 부족하다는 공백을 메웠다. 임상 전문가의 검증, 다중 모델 기반 테스트 및 목표 특이성 기준 설계를 통해, 정서적 표상이 아닌 인지 구조에 초점을 맞춘 최초의 평가 프레임워크를 제시했으며, 모든 도구를 오픈소스로 제공한다.

진행 상황 및 관련 보도

AI의 광군절 미스터리: 판매자는 이미 결제했지만, 사용자는 단지 할인 혜택만 챙기고 있다

2026년 더블 11 기간 동안 AI 상용화는 뚜렷한 양극화를 보였습니다. 판매자 측에서는(예: Qwen Office 이커머스 버전) 이미 유료화가 실현되었으며, 유료 사용자의 20%가 이커머스 업계에서 나왔습니다. 반면 소비자 측은 도우바오, Qwen 등 배포 채널의 보조금에 의존해 주문을 유도하고 있으며, 가격 차이는 37.5%에 달하지만 사용자 신뢰도는 낮아(단지 16.06%만이 AI가 상품을 정확히 매칭할 수 있다고 믿음) AI 쇼핑 안내가 아직 전통적인 의사결정 경로를 진정으로 대체하지 못한 상황입니다.

추천 이유:본 자료는 티에이미디어가 2026년 10월 26일에 발표한 심층 보도를 바탕으로 작성되었으며, AI가 더블 11 기간에 보여준 세 가지 유형의 활용 사례를 체계적으로 정리했습니다: ① AI 쇼핑 가이드의 거래 단계로의 확산(더우바오/천원이 주문 및 결제 지원); ② 토큰 서비스의 티몰·징둥 입점(첫날 매출 전일 대비 +450% 증가했으나 판매량은 여전히 초기 단계); ③ 상인용 도구의 선도적 수익화(천원 오피스의 비용 절감 사례가 명확히 제시되며, 알리바바 계열 경영 시스템에 연동됨). 모든 사실은 본문에서 명시된 시점, 데이터 및 출처에 근거하며, 외부 추론은 포함되지 않습니다.

진행 상황 및 관련 보도