本文へ移動
AI NEWS JOURNAL
FOLLOW THE THREAD

研究与论文

テーマに沿って、新しい事実とその後の進展を追います。

公開日時順

新たな研究によると、AIモデルの利用コストは言語によって大きく異なり、トークン消費量には最大で17倍もの差が生じる可能性がある

IT之家 10月30日付の報道によれば、利用者数が少ない言語を用いるユーザーは、英語やその他の主要言語のユーザーに比べて、AIサービスを利用する際により高い料金を支払う必要がある場合があるという。現地時間28日、海外メディアRest of Worldの報道によると、人工知能言語公平性研究連盟が先月発表した研究では、AIモデルが異なる言語を処理する際、消費するトークン(単語要素)の数に大きな差が生じることが明らかになった。トークンとは、AIモデルがテキストなどのデータを処理する際の基本単位であり…

新研究称AI模型使用成本受不同语种影响,Token消耗量最高可相差17倍
経緯と関連報道

GitHubがCopilot Fusionを発表、複数モデルの自動オーケストレーションでコーディング効率とコストパフォーマンスを向上

GitHubはUniverse 2026において、Copilot Fusionというインテリジェントなオーケストレーション層を公開しました。この層は、OpenAI、Anthropic、Googleなどのモデルを自動的にルーティングし組み合わせてコーディングタスクを実行できるため、開発者は手動でモデルを選択する必要がありません。既存の自動モデル選択技術と、9月に研究としてプレビューされたProject HydraFusionの多モデル編成機能を統合しており、モデルセレクターを有効にすると、システムはタスクの複雑さに応じて単一モデル、カスケード、レビューといった実行モードを自動的に採用します。

QQ20261029-155714.jpg
経緯と関連報道

CVE脆弱性の件数がほぼ垂直に急増、AIがセキュリティ研究の「増幅器」に

テクノロジーメディアgigazineは、開発者@0x_Ospreyがウェブ版CVE Trackerを公開し、既にCVE番号を取得した脆弱性の件数変化を可視化したグラフを作成したと報じました。このグラフでは、2026年以降、曲線がほぼ垂直に上昇していることが示されています。CVEは世界共通の脆弱性識別番号体系で、セキュリティ研究者やベンダー、企業が欠陥を追跡・報告・修復する際に利用しています。同ツールは公開された記録を整理してトレンドグラフにまとめるとともに、主要なAIモデルの公開時期も重ねて表示しており、脆弱性の増加とAIのリリースとの関連性を直感的に比較できるようになっています。

CVE 漏洞数近乎垂直拉升,AI 成安全研究"放大器"
経緯と関連報道

アナログ重ね合わせが有効なPCMの記憶密度を向上(IBMリサーチヨーロッパ)

IBMリサーチヨーロッパの研究者らは、「ニューラルネットワークにおけるベクトル格納のための重ね合わせ型アナログメモリ」を発表しました。要旨:研究者たちは、複数のAIベクトルを重ね合わせて格納するアナログ相変化メモリアーキテクチャを実証し、精度の調整可能なトレードオフにより有効な記憶密度を向上させました。試作のPCMハードウェアによるテストでは、推論精度がフル精度のソフトウェアにほぼ匹敵することが示されました。技術論文はこちらからご覧ください…… » 続きを読む 「アナログ重ね合わせが有効なPCMの記憶密度を向上(IBMリサーチヨーロッパ)」の記事は、Semiconductor Engineeringに最初に掲載されました。

新闻源配图 · SemiEngineering
経緯と関連報道

AIが認知症を抱える数百万人の生活における発見のスピードをどのように変えているか

今日、世界では5,700万人が認知症を抱えています。彼らを支援しようとする研究者たちにとって、障壁となっているのは努力不足ではなく、データが過剰であり、それを統合する専門家が不足していること、そして疾患の進行に追いつかないほどの発見のペースです。[…]における生物医学研究とAIに関するコンソーシアムは…

新闻源配图 · NVIDIA Blog
経緯と関連報道

レックス・フリードマンのポッドキャスト精読|AIの衝撃下で、数学者には何が残るのか?

レックス・フリードマンの今回の回は、13のテーマに分かれています。ゲストは3名で、ワシントン大学で流体力学を研究するスティーブン・ブラントン、MITで理論計算機科学に取り組むアンカー・モイトラ、そしてラトガース大学で数論とLeanを研究するアレックス・コントラヴィチです。動画では、ナビエ–ストークス方程式、リーマン予想、計算複雑性理論について議論されており、その背景には、わずか数週間の間にAIがこれらの分野で未解決だった難題を相次いで解明したと発表されたことがありました。3人の数学者はそれぞれの専門的視点から、それらを丁寧に分解して解説しています…

Lex Fridman播客精读|AI冲击下,数学家还剩下什么?
経緯と関連報道

Edge Soundは、物理的なAIが音声を理解できるよう支援するために200万ドルを調達しました

Edge Sound Research Inc.は本日、有用な音を分離し、他のセンサーデータと組み合わせて物理AIシステムがリアルタイムで状況を理解できるよう支援する音響インフラの構築に向け、新たに200万ドルの資金調達を行ったことを発表しました。このラウンドはStormbreaker Venturesがリードし、同社の総資金調達額は900万ドルに達しました。当該[…] 記事「Edge Sound、音声を物理AIが理解できるようにするための200万ドルを調達」は、元々SiliconANGLEに掲載されたものです。

経緯と関連報道

蒸留、議論、発見:グラフから抽出されたインサイトに基づくマルチエージェント研究アイデア創出

arXiv:2610.33366v1 公表タイプ:新規 要旨:大規模言語モデル(LLMs)は、研究アイデアの生成や科学的発見を支援するためにますます活用されています。マルチエージェントによるディベートは、多様な視点を結集して研究アイデアを生み出す協調的な手法です。しかし、重要な課題は、各エージェントにそれぞれ独自で有意義な専門知識を持たせ、その貢献を適切に導く方法を見いだすことです。研究者が共同作業の過程で蓄積された研究成果を活用するように着想を得て、私たちはInsightAgentsというフレームワークを提案します。これは、関連論文のグラフからインサイトを蒸留することで、文献に基づいたエージェントの専門知識を構築するものです。研究の一貫性を追跡し、背後にある仮定を明らかにし、未解決の課題を特定するといったインサイトに導かれながら、ある研究分野において

経緯と関連報道

執筆アドバイスから原稿ガバナンスへ:学術的改訂のための制約付き変換フレームワーク

arXiv:2610.33001v1 発表タイプ:新規 要旨:学術的な改稿は、正当な執筆上の目的が衝突する場合、ガバナンス上の問題を生じさせる。執筆プロセスおよび社会科学の研究は、改稿が再帰的であり、文言には認識論的・学問分野固有の約束が伴うことを示している。これらの文献は重要な制約を特定しているものの、簡潔さや掲載媒体の形式、文体の多様性が証拠や主張の境界と対立する際に、どの目的を優先すべきかについては明確にしていない。本論文では、改稿を順序付けられた制約下での許容可能性の問題としてモデル化する。タスクに依存する不変量、文脈上の制約、そして変更可能な表現選択が許容可能な領域を定義し、証拠と判断を認可された主張の境界に結び付ける主張保持契約が設定される。さらに、四つのガバナンスに関する命題が具体化される。

経緯と関連報道

溶媒:多段階逆合成における長期的視野による推論

arXiv:2610.32308v1 発表タイプ:新規 要旨:多段階の逆合成反応では、目的分子を連続する反応ステップを通じて購入可能な構成要素へと再帰的に変換する必要があります。近年の研究では、この課題に取り組むために大規模言語モデル(LLM)による推論が活用され始めています。その最新の進化において、LLMによる推論は長期的な視野の領域へと拡張されました。すなわち、モデルは相互依存的な各ステップにわたって目標を追求し、環境と相互作用しながらフィードバックに適応します。このような変化により、AI主導の数学研究における画期的な成果が示されるなど、LLMの能力は著しく向上しています。この最先端の領域において、我々はSolventを提案します。これは8B規模のLLMであり、長期的な視野での推論を多段階の逆合成反応へと効果的に拡張することに成功しました。二段階の事後訓練カリキュラムを通じて、Solventは反復的な処理を織り交ぜる能力を習得します

経緯と関連報道

DPOの微調整により、持続可能な金融に関する用語定義の生成品質が向上し、EUにおける開発資金調達文書の意味変化の監査を支援

2026年10月27日付でarXivに掲載された研究(arXiv:2610.33357v1)は、直接的嗜好最適化(DPO)を用いて辞書式定義生成モデルを微調整することで、語彙の意味変化検出(LSCD)において生じる過剰な意味項の細分化問題を効果的に緩和し、EUの開発資金調達プロジェクト文書における持続可能性関連用語の経時的変化の監査をより高精度に支援できると示している。

注目する理由:本研究は、意味変化分析における定義生成モデルの実際の課題である「意味項の過剰な細分化」に対処するため、再現可能でオープンソース化された技術的改良手法を提案し、学術的なベンチマークおよび実際のEUの持続可能な金融開示文書上で二重の検証を完了した。公開日は現在の日付(2026-10-28)よりも前であり、最新の公表研究成果である。

経緯と関連報道

投研Agentの開発者である陳万氏は、自作コードを削減し、テンセント元宝の検索APIを導入することで、財経情報の検索効率を向上させました。

2026年10月26日、新エネルギー産業チェーンの有料投研レポート作成者である陳万は、2年間にわたり維持管理してきたcleaner.py(ウェブページクリーニングスクリプト)およびsites.yaml(387件の情報源URLリスト)を削除し、テンセントクラウドがアップグレードした元宝検索API(SearchPro)へ正式に接続しました。テスト結果によれば、同APIは構造化要約、時効性の識別、権威ある情報源の区分(VRカード)、ならびに多次元検索パラメータのサポートにおいて、従来のソリューションを大きく上回り、人手による情報源の保守作業時間を深い研究へと振り向けることを支援しています。

注目する理由:本資料は、2026年10月26日にInfoQが公開した実地の技術実践レポートに基づいており、開発者の実際のワークフローの進化を包括的に示しています。具体的には、ウェブページの解析ルールや情報源のホワイトリストを手動で維持管理する段階から、専用のネットワーク検索APIを活用して自動化・検証可能かつ時効保証のある情報取得へと移行する過程を追跡しています。イベントの日時は明確に記載されており(publishedAt: 2026-10-26T14:57:35Z)、主体も明確で(陳万)、実施されたアクションも具体的です(2つのファイルの削除+SearchProへの接続)。さらに、その効果も検証可能であり(カバレッジ率の目標達成、追加質問の減少、681msでの自動呼び出し)、技術的な詳細(パラメータ、課金体系、MCPプロトコルのバージョンなど)はすべて原文に厳密に由来しており、外部からの推測や虚構は一切含まれていません。

経緯と関連報道

AIの壊滅的リスクが日常的な被害を覆い隠す——専門家ら、技術責任基準の再構築を訴える

『MITテクノロジーレビュー』2026年10月26日号は、現在のAI安全政策が自殺誘発や麻薬取引といった極端なリスクに過度に焦点を当てている一方で、AIパートナーへの依存、認知能力の低下、社会的関係の侵食など、日常的に広く見られる危害については体系的に見落としていると指摘している。記事は、Googleが推進する規制緩和型の州レベルのAI立法、Metaプラットフォームによる被害事例、そしてMITの脳イメージング研究を根拠に、単なる「悪を行わない」という最低限の基準を超えて、学習効果、感情の真実性、自律的思考能力に対する実質的な説明責任の確立が必要であると強調している。

注目する理由:本稿は、権威あるテクノロジー系メディアが事件発生当日(2026年10月26日)に掲載した詳細な評論であり、情報源は明確で(technologyreview.com)、核心的な主張は公表されている立法の進展(カリフォルニア州SB1119、ネブラスカ州法案など)、実証研究(MITの脳接続データ)、業界における経歴(サム・ハイナーおよびエマ・ライケンの公的な役職と功績)、ならびに検証可能なグローバルプラットフォームによる被害の記録(ミャンマー、スリランカ、エチオピア)に基づいています。すべての事実の記述は原文に厳密に照らし合わせられており、外部からの推論や補足は一切含まれていません。

経緯と関連報道

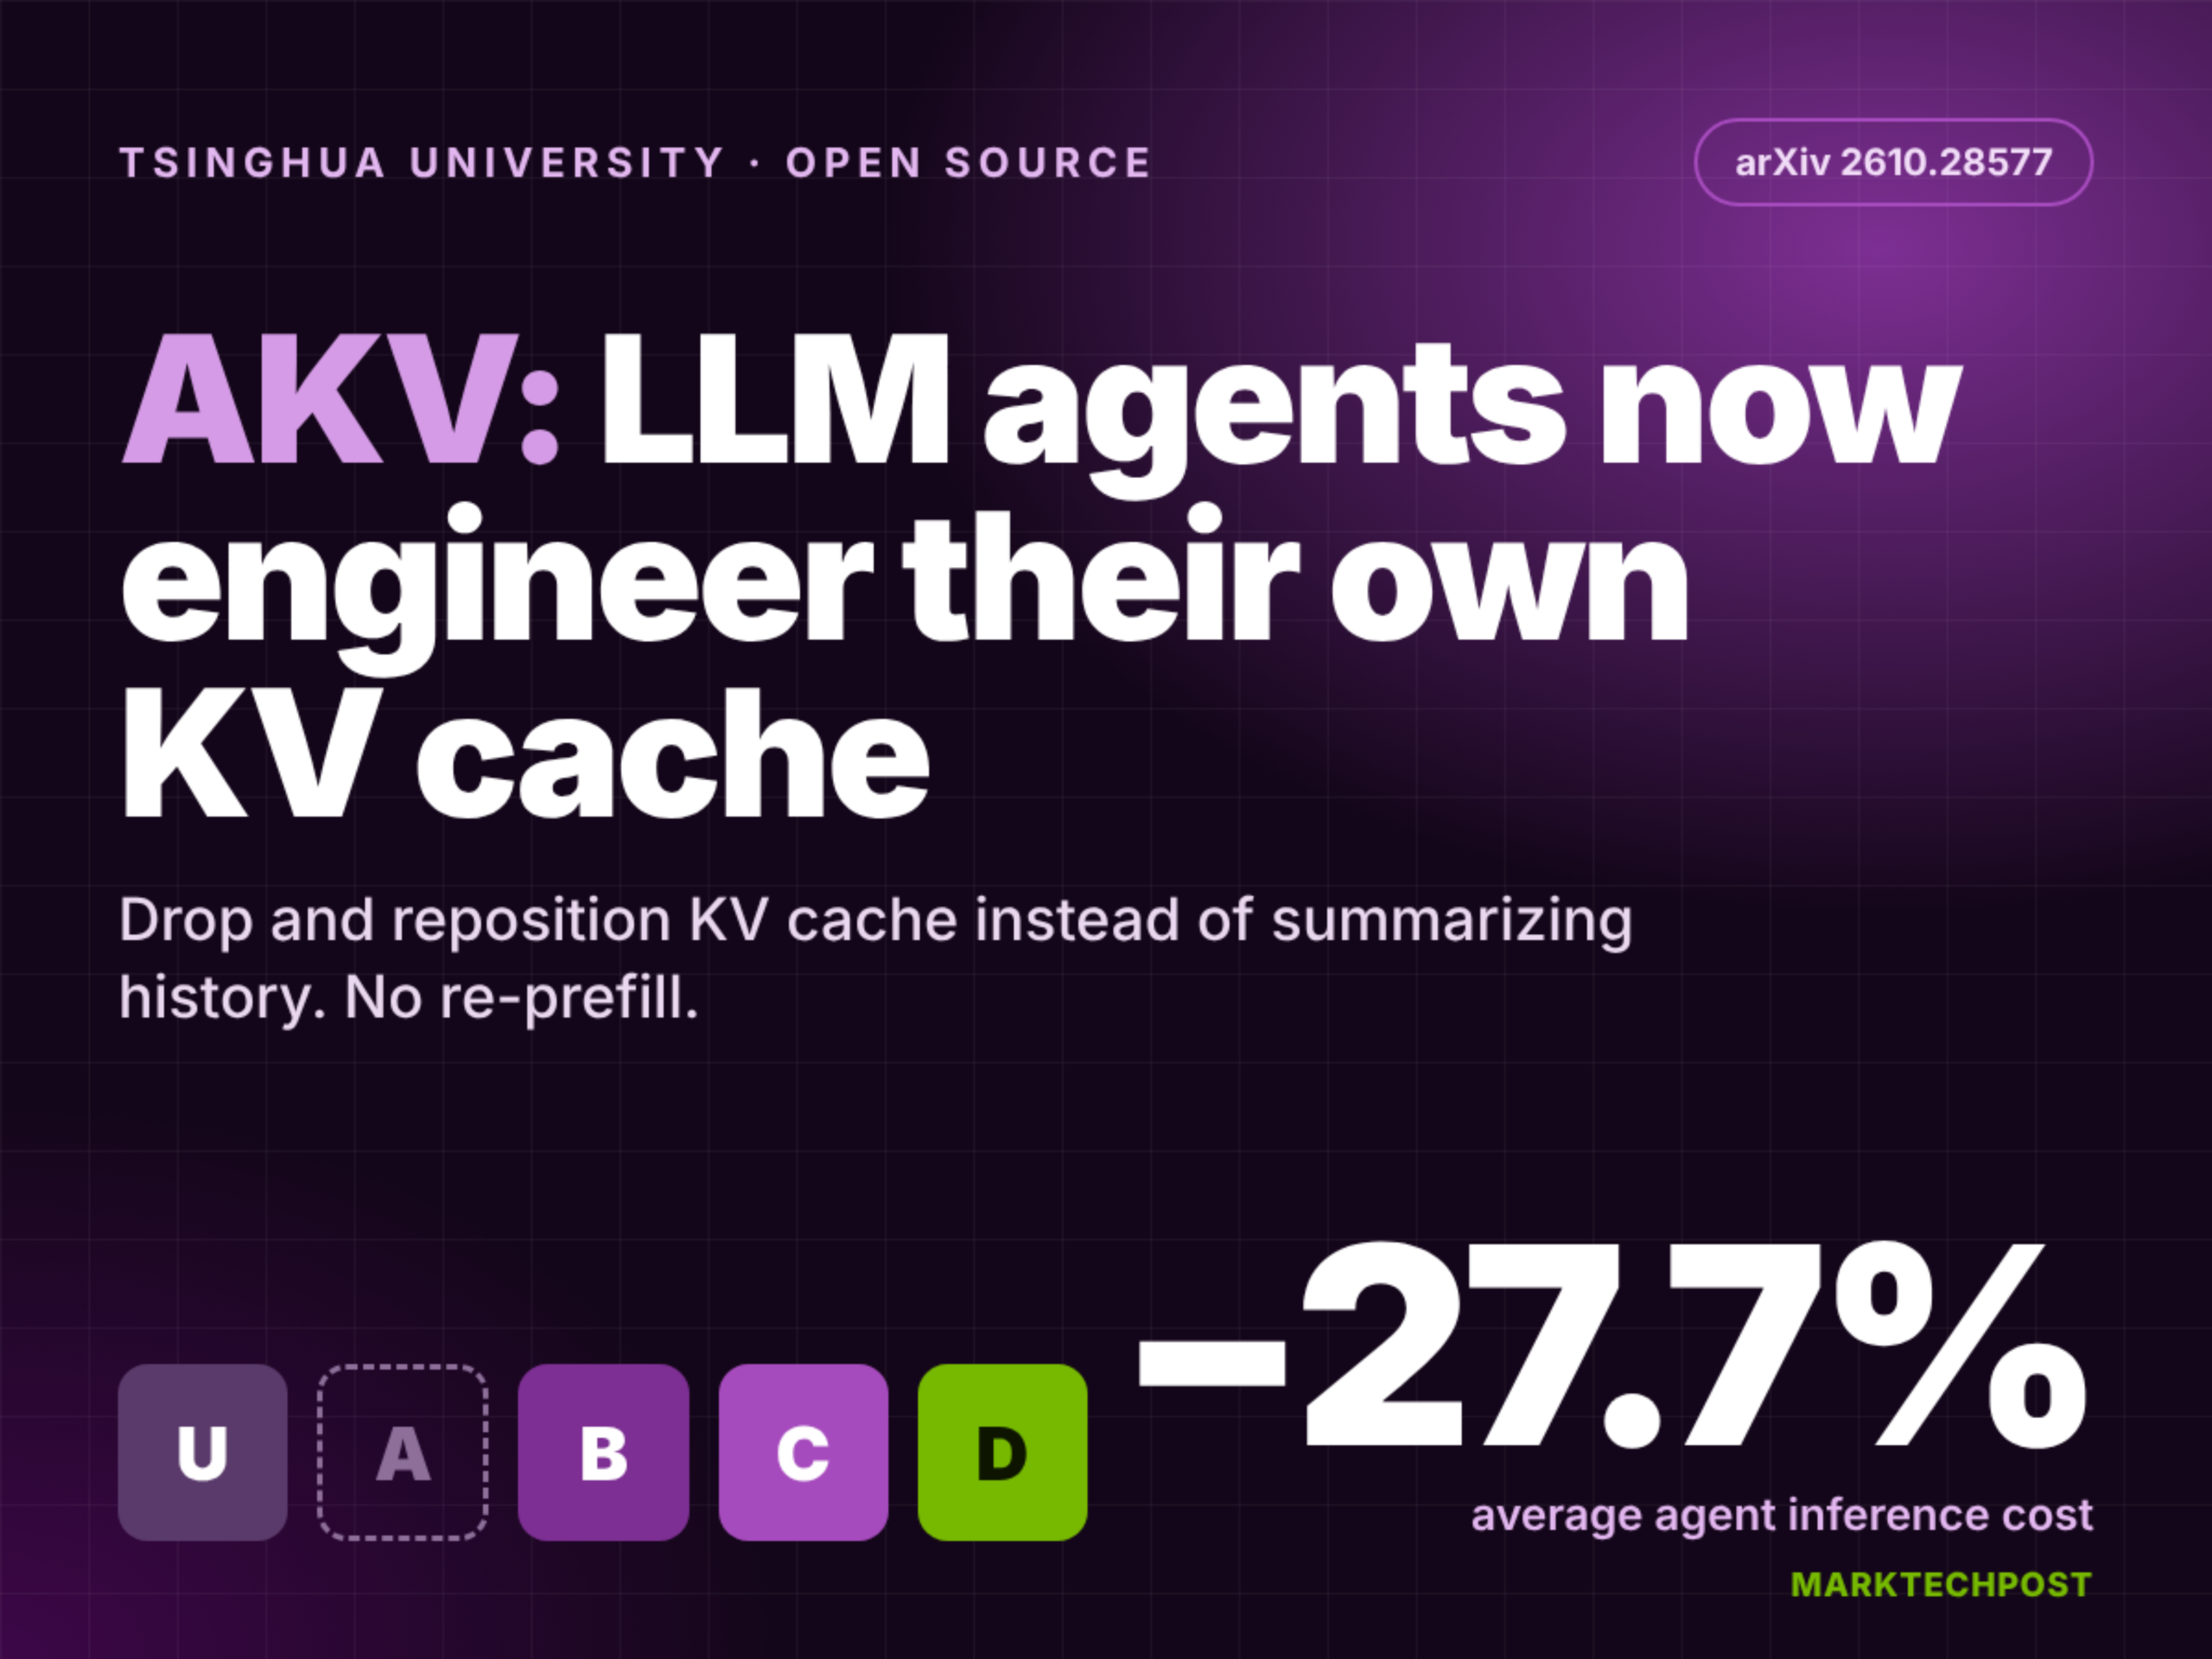
清華大学と香港中文大学が共同でAKVをオープンソース化:LLMエージェント向けのKVキャッシュエンジニアリングサービスシステム

清華大学と香港中文大学の研究者らは、2026年10月26日、SGLangを基盤とし、大規模言語モデル(LLM)エージェント向けに設計されたKVキャッシュ用のエンジニアリングサーバーであるAKVをオープンソース化しました。このシステムは、従来のテキスト履歴の要約ではなく、エージェントが自らKVキャッシュを積極的に破棄・再配置することで、4つのエージェントベンチマークにおいて推論コストを平均27.7%削減し、タスクの平均スコアを1.7ポイント向上させました。コードはApache-2.0ライセンスのもとで公開されており、現在はQwen、GPT-OSS-120B、MiniMax-M2.7などのモデルをサポートしています。

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

注目する理由:この成果は、LLMエージェントによる効率的な推論の新たなパラダイムを示しています。テキストの切り捨てや要約に依存する「コンテキストエンジニアリング」とは異なり、AKVはKVキャッシュ状態を直接操作することで、重複したプリフィルを回避し、長距離間の相互作用におけるKV負荷を大幅に軽減します。実測では、高並行負荷下でP95遅延が229.9秒から30.6秒へと短縮され、明確な工学的価値と再現性を備えています。情報源はMarkTechPostが公開した権威ある技術レポートであり、公開日時(2026-10-26T07:56:45Z)は現在時刻と一致しており、最新の公表進展です。

経緯と関連報道

改ざんされた機械学習:大規模言語モデルによる機械学習研究の評価

arXiv:2610.32114v1 公表タイプ:新規 要旨:AIアライメントの進展を加速する一つの手法は、アライメント研究そのものの一部を自動化することである。そのためには、研究提案における欠陥の特定や、提案された実験が意図した主張を支持するかどうかの評価といった、監督が困難な研究課題に対しても信頼性高く機能するシステムが必要となる。この能力を評価するため、我々はTampered MLを導入する。これは、公開されている機械学習論文から再構成された実験提案と、目的とした方法論的欠陥を導入した最小限に編集された対照案からなる、1,858組の項目ペアからなるベンチマークである。モデルは、提示順序に関わらず、より方法論的に妥当な提案を識別しなければならない。層化抽出サンプルに基づく人間による検証研究では、全体の86%が…

経緯と関連報道

SAGEベンチマークとGARフレームワークの公開:マルチモーダルな意味的整合性評価の推進

2026年10月26日、arXivは論文arXiv:2610.31838v1を公開し、Sense-Aligned Grounding Evaluation(SAGE)——統一された10候補画像選択基準——を提案するとともに、名詞・動詞・実体中心の多モーダルなグラウンディング評価を実施するための、学習非依存型のGloss-Augmented Reasoning(GAR)フレームワークも併せて提示した。

新闻源配图 · arXiv cs.CL

注目する理由:本研究は、VWSD、VerSe、WikiDiverseの3種類のタスクを用語中心のグラウンドトゥルース評価プロトコルに統一し、混同行動による難負例の導入とコンテキスト交換による診断メカニズムを提案しました。さらに、定義の強化と制約による推論の誘導が協調して作用することでHits@1指標を大幅に向上させること(65.90→71.22)を実証し、マルチモーダルな意味対応の評価においてより細粒度で解釈可能な新たなパラダイムを提供しています。

経緯と関連報道

研究は、自閉症と非自閉症の個々の対人対話における成功の知覚を予測するための多モーダル手法を提案している

arXivに掲載された新たな研究(番号2610.31682v1)では、言語運動、顔面表情、音声の韻律、話の交替といったマルチモーダルな特徴を用い、自閉症者と非自閉症者の参加者が含まれる3つの自然な二人間対話データセットにおいて、対話の成功度に対する各参加者の主観的認識を予測しました。

Multi modal perceived conversation success prediction for spontaneous autistic and non-autistic dyadic interactions

注目する理由:本研究は、従来の診断分類や単一モダリティによる分析にとどまる限界を克服し、補完的な多モダリティの行動指標を初めて体系的に統合して、「知覚された対話の成功」という社会的コミュニケーションの核心次元をモデル化しました。これにより、神経多様性を持つ人々のコミュニケーション支援技術の向上に向けた新たな方法論的根拠を提供しています。本論文はすでに公開されており、タイムスタンプは現在のシステム時刻と一致しており、最新の学術進展に該当します。

経緯と関連報道

研究により、ラテン語専用の言語モデルLAMBおよび2つの新しいコーパスAcervusとCorpus Trinumが公開されました

2026年10月26日、arXivは論文arXiv:2610.31723v1を公開し、ラテン語専用のエンコーダーであるLatin Modern BERT(LAMB)を提案しました。同モデルはModernBERTアーキテクチャに基づき、二段階の事前学習を経て、740億語以上のラテン語トークンと新たな形態素認識型マスク戦略を用いています。同時に、2つの全く新しいラテン語コーパスも公開されました。1つは240億語のAcervusで、76万件のByT5によるOCR修復済み破損テキストを含みます。もう1つは、世界初の人工的に構築されたラテン語の意味三項対象データセットCorpus Trinumで、強/弱の三項対象が1億以上収録されています。

新闻源配图 · arXiv cs.CL

注目する理由:本研究は、古典言語NLPの基盤資源における空白を埋め、ラテン語の意味理解向けの大規模な事前学習モデルとそれに伴う評価基準を初めて体系的に構築した。さらに、厳密な実験によりLAMBが17のサブタスクのうち16項目で優位性を示し、明確な技術的貢献と再現性を備えていることを実証した。なお、すべての結論はarXiv論文の要約および事実抽出内容に厳密に対応しており、外部情報は一切導入していない。

経緯と関連報道

新たな研究により、強化学習における既存のCriticを大規模言語モデルの信頼度推定器としてそのまま再利用できることが明らかになった

2026年10月26日にarXivに掲載された(番号2610.31820v1)AI研究論文は、価値ベースの強化学習(value-based RL)で訓練された大規模言語モデル(LLMs)について、既存のCriticモジュールが追加の学習やデータなしで、高精度かつ高信頼性の信頼度推定器として利用可能であることを示している。

新闻源配图 · arXiv cs.CL

注目する理由:本研究は、信頼度推定と強化学習におけるCriticの学習が、正しさの評価基準の下で数学的本質において等価であることを明らかにし、さらに十数の分野(数学、コード、ツール呼び出し、汎用推論)にわたる実証を通じて、Criticを再利用する手法の有効性と一般化能力を示した。この成果は、LLMの信頼性の高い導入・運用のハードルを低減するうえで、直接的な工学的価値を有している。

経緯と関連報道