本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

ReMoVe:一貫性のある人物動画生成のためのビデオモデル独自の動きの精緻化

arXiv:2611.18666v1 発表タイプ:新規 要旨:ビデオ生成モデルは、リアルな人間の動きを合成する能力を着実に向上させてきましたが、その動きを現実的にするための構造そのものを失ってしまうことがしばしばあります。生成される人間の動きが複雑化するにつれて、ビデオはフレーム間で進行的な身体の変形や外見のずれといった問題を抱えるようになります。既存のモーション制御手法は、生成を安定させるために明示的な表現を使用していますが、通常は事前に定義されたモーションシーケンスを参照として依存しています。このことは根本的な疑問を投げかけます。ベースとなるジェネレーターがすでに使用可能な粗いモーションを生成しているのに、なぜそれを外部のものと置き換える必要があるのでしょうか。ReMoVeは、この疑問に答えるため、粗い出力を最終結果ではなくモーション仮説として扱います。ReMoVeは基礎となるモーションを復元・精緻化し、その精緻化されたモーションを3Dメッシュとしてレンダリングした上で、顔の外見を転写することで、モーションの精度とアイデンティティの一貫性を向上させます。さらに、同じ3Dシーンとカメラ軌跡から深度を導出し、メッシュを超えたシーンレベルでの空間的一致性を強制します。メッシュと深度の両方にビデオ生成モデルを共同で条件付けることで、ReMoVeは制御可能なカメラ軌跡と強化された時空間的一致性を備えた高品質なモーションビデオを合成します。広範な実験により、ReMoVeが人間の構造的安定性、外見の一貫性、時間的整合性、およびモーション追従の忠実度を向上させるとともに、ベースジェネレーターのモーション事前分布を保持し、正確なカメラ制御を提供することが示されています。
Inkling 2 SmallがAI Gatewayで利用可能になりました

コーディングエージェント、視覚的理解、専門知識作業をサポートするマルチモーダル推論モデルであるInkling 2 Smallが、AI Gatewayで利用可能になりました。テキストと画像の入力を受け付け、テキスト出力を生成するため、拡張されたコーディングタスク、情報収集のためのツール利用、ドキュメント生成、および画像内のテキスト読み取り、チャートの解釈、インターフェースの検査を含む視覚分析が可能です。このモデルは、識別子 'thinkingmachines/inkling-2-small' を使用してVercel CLI経由で利用でき、Claude Code、Codex、Cursorなどのツールに統合できます。AI Gatewayは、利用状況の追跡、コスト監視、再試行設定、フェイルオーバー、パフォーマンス最適化、カスタムレポート、Zero Data Retention、予算管理、ルーティングルールなどの機能を備えた統一APIを提供します。価格はプロバイダー料金を反映しており、Bring Your Own Keyリクエストを含め、マーケアップやプラットフォーム手数料は一切かかりません。

Gemini Decision 1がAI Gatewayで利用可能になりました

GoogleのGemini Decision 1は、テキスト、画像、音声、動画、PDFをサポートするマルチモーダルな意思決定モデルで、現在AI Gateway経由で利用可能です。出力トークンを生成せずに、リクエストルーティング、ポリシーチェック、ツールフィルタリング、結果のランキングなどのタスクに対してブール値の確率、選択肢、スコアを提供します。AI SDK、TypeSafe互換API、Decisions APIでサポートされており、AI SDK 7ではPDF、音声、動画の入力が利用可能です。Decision呼び出しはログに記録され、他のモデルリクエストとともに予算にカウントされます。

vercel doctorでVercel CLIのセットアップ問題を診断する

Vercel CLIには、CLIのバージョンとインストール状況、ログインステータス、チーム所属、プロジェクトのリンク状態、vercel.json設定、およびVercelステータスページのアクティブなインシデントを確認してセットアップの問題を診断するvercel doctorコマンドが追加されました。結果はOK、Warning、Failed、またはSkippedとして報告され、具体的な修正コマンドも提供されます。このツールはログインやプロジェクトのリンクを必要とせずに実行でき、--jsonオプションによるJSON出力をサポートしており、コーディングエージェントとの連携に利用できます。

インストール前およびインストール中に悪意のある npm パッケージをブロックする

Vercelは現在、動的なブロックリストを使用して、ビルドにおける依存関係のインストール前およびインストール中に悪意のあるnpmパッケージを積極的に検出しブロックし、有害なスクリプトの実行を防止しています。このシステムはサポートされているロックファイルと公開npmダウンロードをスキャンし、ブロックされたパッケージが検出された場合にデプロイを自動的に失敗させ、問題のパッケージとバージョンを特定し、ビルドキャッシュの無効化を試みます。ユーザーは安全な依存関係バージョンに更新し、ロックファイルを再生成してから再デプロイする必要があります。これらのセキュリティ対策は設定不要で、すべてのプランに自動的に適用されます。

フェアなディープフェイク検出のための交差的不変学習

arXiv:2610.37881v1 発表タイプ:新規 要旨:ディープフェイク検出モデルは全体的な精度は高いものの、人口統計上の各グループ間で性能に大きな偏りが見られ、一部のグループでは他のグループに比べて偽陽性率が著しく高くなるという問題があります。既存の公平性を考慮した手法は、モデルの出力を制限してグループ間の予測結果を均等化することによってこの問題に対処していますが、根本的な特徴レベルのバイアスには対処していません。その結果、モデルは依然として肌の質感など、人口統計的特性を操作されたコンテンツを検出するための間接的な手がかりとして利用してしまう可能性があります。この問題を解決するために、我々は交差的不変学習(IIL)というフレームワークを提案します。これは、単にモデルの出力を調整するだけでなく、特徴学習自体を改善するものです。IILでは、最も困難な人口統計的区分を特定することを繰り返し行い

経緯と関連報道

アーティファクト蒸留:フロンティアモデルから小型言語モデルへの訓練不要な転移

arXiv:2610.37680v1 発表タイプ:新規 要旨:フロンティアモデルと小型言語モデルの性能差を埋める手法としては、通常は蒸留が用いられます。すなわち、フロンティアモデル(教師)の出力に対して小型モデル(生徒)を微調整することで転移を行いますが、この方法では転移に必要な計算コストが伴う上、転移された知識はほとんど不透明なままです。そこで私たちは「アーティファクト蒸留」を提案します。これは、教師モデルが学習課題を解き、その問題解決手順を外部にアーカイブしておき、生徒モデルが推論時にそのアーカイブを参照するという手法です。これにより、勾配による更新は一切不要となります。LiveBenchの4つのタスクにおいて、Claude Opus 4.5が作成したアーカイブを用いることで、Claude Haiku 4.5は空間的推論において、コストを60%に抑えながら、無補助のClaude Sonnet 4.5を0.707対0.647で上回り、テーブル結合タスクではコストを89%に抑えた上でSonnet 4.5と同等の性能を達成しました。さらに、同じ生データのアーカイブを用いることで

経緯と関連報道

fxアダプターは現在、ホスト上でハーネスを実行しています

AI SDK の HarnessAgent 用 fx アダプタは、libfx を使用するようになり、ハーネスおよびモデルのリクエストをアプリケーションのプロセス内で実行できる一方で、ファイルシステム操作やシェル操作はサンドボックス内で分離されます。このアップデートにより、サンドボックスに fx をインストールしたり、ブリッジを起動したり、ポートを公開したりする必要がなくなるため、セットアップが簡素化されます。モデルの認証情報はホスト側に残ります。新機能には、組み込みのツールフィルタリング、ターン中ステアリング、構造化出力、toModelOutput() を介した画像ツール結果、およびホスト間プロセスでのセッション再開が含まれます。これらの改善を利用するには、@ai-sdk/harness-fx を最新バージョンに更新してください。

INC-MoE:エキスパート並列型混合専門家推論における、ネットワーク内コレクティブの重複と専門家計算

arXiv:2610.36339v1 発表タイプ:新規 要旨:エキスパート並列型混合専門家(MoE)のサービスにおいて、ディスパッチは各トークンをその選択された専門家が配置されているアクセラレータへ送り、コンバインは各トークンの所有者に専門家の出力を集約して返します。これら両操作はクリティカルパス上に位置し、マルチノード環境ではMoE層のレイテンシを大きく左右します。本研究では、ディスパッチとコンバインをネットワークスイッチにオフロードし、さらに両コレクティブを相互に、および専門家計算と重ね合わせるエキスパート並列型MoE層であるINC-MoEを提案します。ディスパッチはスイッチ側のマルチキャストによるネットワーク内AllGatherを用い、コンバインはスイッチ側のリダクションによるネットワーク内ReduceScatterを用います。両コレクティブとも、エンドホストとスイッチ間でメッセージセマンティクスを利用します。なお、ネットワーク内コレクティブはそれぞれ逆方向に負荷をかけるため

経緯と関連報道

トランスフォーマーにおける証拠効果の因果的局所化

arXiv:2610.36524v1 公告タイプ:新規 要旨:制御された記号入力は、自然言語による証拠から言語モデルの意思決定に影響を与える注意ヘッドを明らかにすることができるのか?我々は、制御された証拠集約(CEA)を提案する。これは、他の部分が固定されたプロンプトにおいて、二つの記号の出現回数と順序を変化させ、凍結されたトランスフォーマーが二つの回答トークンの間で示す選好の変化を測定する手法である。選好は両者のロジット差によって測定され、プロンプト自体には正解が指定されていない。バランスド・ユーティリティ・カウサル・セレクション(BUC)は、各ヘッドの出力を除去した際にカウント効果がどの程度消失するか、またカウント条件間で平均出力を補間することで両方向に効果がどの程度回復するかを同時に評価することにより、コンパクトなヘッド集合を特定する。さらに、ヘッドの帰属と介入との間に結びつく条件付き上限を導出する。

経緯と関連報道

あなたのAIエージェントにも最高執行責任者が必要です

AIエージェントのスケーリングには、規制対象の役割を担う従業員と同様に扱い、文書化されたルール、明確に定義された責任、そしてそのパフォーマンスに責任を負う名指しの人的管理者を配置することが必要です。ゲスト著者のリック・フォルグマン氏(Get Covered社COO)は、企業に対し、まず既存のルールで管理されているタスクから着手し、各ワークフローのリスクに応じて自律性を調整したうえで、エージェントの権限を拡大する前に定期的に成果をレビューすべきだと述べています。

新闻源配图 · Crunchbase AI
経緯と関連報道

n8n@3.0.0

# [3.0.0](https://github.com/n8n-io/n8n/compare/n8n@2.45.0...n8n@3.0.0) (2026-10-27) ### 不具合修正 * アーティファクトのダウンロードボタンにファイルタイプのツールチップを追加 ([#41490](https://github.com/n8n-io/n8n/issues/41490)) ([4a74f02](https://github.com/n8n-io/n8n/commit/4a74f027e612f31098b354dd3a77b2c2ab98281c)) * **ai-builder:** 実行の読み込みを確認:アシスタントの実行で読み込みが行われる ([#41863](https://github.com/n8n-io/n8n/issues/41863)) ([a967486](https://github.com/n8n-io/n8n/commit/a9674866d075e989a5ce896432262c9a7dc8b0c7)) * **ai-builder:** 設定されたAIトランスポート経由でアシスタントモデルへの呼び出しを送信 ([#41948](https://github.com/n8n-io/n8n/issues/41948)) ([9b63561](https://github.com/n8n-io/n8n/commit/9b63561cbb48f06d216f27be3b77722d97e4e74a)) * カスタムOAuth2スコープを許可 ([#41249](https://github.com/n8n-

経緯と関連報道

n8n@2.46.0

# [2.46.0](https://github.com/n8n-io/n8n/compare/n8n@2.45.0...n8n@2.46.0) (2026-10-27) ### 不具合修正 * アーティファクトのダウンロードボタンにファイルタイプのツールチップを追加 ([#41490](https://github.com/n8n-io/n8n/issues/41490)) ([4a74f02](https://github.com/n8n-io/n8n/commit/4a74f027e612f31098b354dd3a77b2c2ab98281c)) * **ai-builder:** 実行:読み取りを確認 — Assistant の実行で読み取りが行われる ([#41863](https://github.com/n8n-io/n8n/issues/41863)) ([a967486](https://github.com/n8n-io/n8n/commit/a9674866d075e989a5ce896432262c9a7dc8b0c7)) * **ai-builder:** 設定された AI トランスポート経由で Assistant モデルへの呼び出しを送信 ([#41948](https://github.com/n8n-io/n8n/issues/41948)) ([9b63561](https://github.com/n8n-io/n8n/commit/9b63561cbb48f06d216f27be3b77722d97e4e74a)) * カスタム OAuth2 スコープを許可 ([#41249](https://github.com/n8

経緯と関連報道

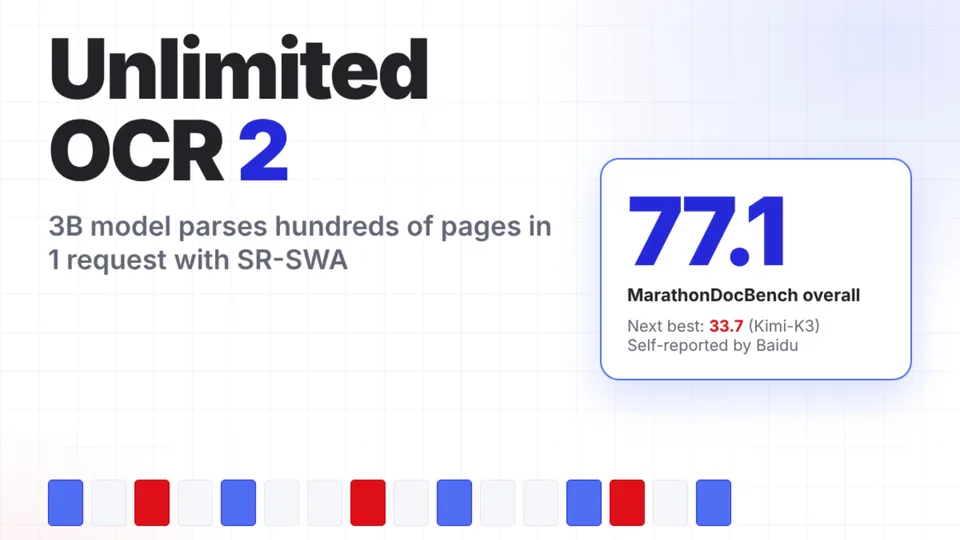
百度が、数百ページに及ぶ文書の解析向けのUnlimited OCR 2をオープンソース化

Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

PRISM:暗黙的な確率的変調による大規模言語モデルのサンプリング多様性の促進

arXiv:2610.32101v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)は、出力分布が既知の意味的なモードに集中する「モード崩壊」を示す。多様性が失われると、繰り返しサンプリングは発見ではなく意味的な反復となり、稀ではあるがより強力な解が表面化しにくくなるため、自己進化や継続的学習の維持が困難になる。ほとんどの対策は推論時のみに介入し、サンプルを調整するだけで、多様性をモデルの能力として組み込むことはできない。そこで私たちは、訓練時に多様性をモデル内部に内蔵するフレームワークであるPRISMを提案する。PRISMは、(i) 各プロンプトに対し、多様でありながら正解でもある複数の教師モデルによる解答を対応付けるサブモジュラー型キュレーションと、(ii) 特殊トークンの摂動を実行可能な形に変換する確率的埋め込み変調を組み合わせている。

経緯と関連報道

LLMエージェントの一貫性を確保するための再帰的意味論的発散

arXiv:2610.33012v1 発表タイプ:新規 要旨:ツール利用を備えた大規模言語モデル(LLM)エージェントは、同一の状態から独立した実行を行った際、異なるツールを呼び出したり、矛盾する出力を生成したり、互いに異なる戦略を採用したりと、一貫性のない挙動を示します。この変動性は時間の経過とともに累積し、デプロイメントの信頼性を損ないます。既存の評価指標は主に完了ベースのスコアによってタスクの正しさを測定しており、実行間におけるエージェントの振る舞いの一致性を捉えられていません。一方で、エージェントの振る舞いは、確率分布を用いたトークンレベルでの分析や、意味クラスタリングによる単一応答レベルでの分析が行われていますが、いずれも軌跡上の将来のターンにわたって不一致がどのように伝播していくかを捉えることはできません。そこで私たちは、Recursive Semantic Divergence(RSD)という手法を提案します。これは未使用の…

経緯と関連報道

大規模言語モデルの信頼性検出のための表現シグネチャーの適応的転送

arXiv:2610.33442v1 公開タイプ:新規 要旨:大規模言語モデル(LLMs)は、ハルシネーションや推論エラーを含む信頼性に関する問題に脆弱であると報告されています。既存の品質検出器は、内部表現に基づいて信頼性の低い出力をある程度の精度で予測できます。しかし、これらの検出器を訓練するには、多くの場合、特定分野に特化した大量のラベル付きデータが必要であり、そのため新たな分野への適用が制限されます。私たちは、この課題に対処するために、関連する複数の分野間で表現シグネチャーを転送することを提案します。具体的には、まず各分野ごとに低次元のシグネチャーを抽出し、次にクロスフィッティングを用いて、分野固有の予測器の組み合わせ重みを学習する統計的枠組みを構築します。この重みは、各ソース分野における予測の重要性に応じて適応していきます。

経緯と関連報道

DMAIC-Bench:多段階の分析タスクにおけるエージェントの自己反省から自己抑制へ

arXiv:2610.32305v1 発表タイプ:新規 要旨:多段階の分析タスクでは、LLMエージェントが次の行動を継続するか、転送するか、あるいは停止するかを判断するために、中間的な証拠を用いる必要があります。エージェントが自身の出力を批判する自己反省は広く研究されていますが、その批判だけでは、証拠が次の行動に影響を与えたかどうかを示すことはできません。私たちはこの能力を「自己抑制」と呼んでいます。既存のエージェントベンチマークの多くは、タスクの完了度や出力品質を測定するだけで、この点については未検証です。DMAIC-Benchは、リーン・シックスシグマの明示的な統計的要件に基づいて構築された、4つの産業分野における15の産業事例にわたる97の種付け済みタスクを用いて、この能力を評価します。対になる反事実的変種では、同じワークフロー上の同一位置で相反する行動を要求し、正当な抑制と無差別な停止を区別します。私たちは実行トレースを用いて評価を行います。

経緯と関連報道